Книга Камераты
Корпоративный ИИ-слой
видение, архитектура, реализация
Как зрелая компания строит и эксплуатирует корпоративный ИИ — от обещаний рынка до промышленной эксплуатации. 12 глав, 20 схем, около 110 страниц.
Глава 1
Введение
О чём этот документ
В последние два года корпоративный ИИ перестал быть темой для отдельных исследовательских команд. Он вошёл в повестку советов директоров, в стратегические планы ИТ-блоков, в KPI владельцев бизнес-направлений. От ИИ ждут не просто «эффекта от внедрения отдельной модели», а изменения того, как компания принимает решения, обслуживает клиентов и управляет внутренними процессами.
Одновременно — и это тоже стало признаком нового этапа — рынок наполнился обещаниями, большинство из которых не выдерживает столкновения с реальностью крупной компании. Готовые ассистенты обещают двукратный рост производительности, агентные платформы — замену офисных команд, облачные API — мгновенный запуск корпоративных ИИ-сервисов. На практике крупный бизнес упирается в одни и те же ограничения: данные не готовы, безопасность не позволяет, инфраструктуры нет, ролей нет, эксплуатации нет.
Этот документ — наш стратегический взгляд на то, как должна быть устроена работа с ИИ в крупной компании. В первой части это не описание продуктов, а изложение того, что мы считаем правильным подходом: какие вопросы нужно задать перед внедрением, какая архитектура решает задачу системно, какие эффекты должны получить и бизнес, и ИТ-блок, какой операционный процесс делает внедрение управляемым.
У документа две основные части, и у них разная природа. Часть I — позиция: как, по нашему опыту, должен выглядеть корпоративный ИИ-контур в зрелой компании и почему именно такой подход работает. Её принципы применимы с любыми инструментами — собственной разработкой, другой платформой, другой командой. Часть II — то, как этот подход реализуем мы: платформа «Камерата», шлюз безопасности «Камерата AI Guard», Внешний офис ИИ и обучение. Мы говорим об этом прямо, чтобы читатель всегда понимал, где заканчивается методика и начинается наше предложение. Заключительная глава 12 сводит обе части в карту выбора стартовой точки.
Кому адресован документ
Документ ориентирован на руководителей, отвечающих за стратегию использования ИИ в крупной компании:
- CIO и руководителям ИТ — тем, кто отвечает за инфраструктуру, безопасность, эксплуатацию и совокупную стоимость владения ИИ-стеком.
- CDO и руководителям по данным — тем, кто отвечает за качество, доступность, governance и lineage данных, без которых ИИ-проекты не работают.
- CTO и архитекторам — тем, кто проектирует целевое состояние ИТ-ландшафта и принимает решения по стеку, интеграциям, развёртыванию.
- Владельцам бизнес-направлений — тем, кто формулирует бизнес-сценарии, оценивает эффект и принимает решение, во что инвестировать.
- Руководителям ИБ — тем, кто отвечает за защиту данных, соблюдение требований регуляторов, контроль за тем, что и куда уходит за периметр.
Документ написан так, чтобы каждая из этих ролей нашла в нём ответы на свои ключевые вопросы. Это означает, что местами мы намеренно говорим на двух языках одновременно — на бизнес-языке (про результат, эффект, скорость) и на инженерном (про архитектуру, контур, доступы, эксплуатацию).
Как устроен документ
Документ построен как сквозной нарратив — от диагностики проблемы к деталям реализации. Каждая глава отвечает на конкретный вопрос и подводит к следующей:
- Глава 2 — что происходит с корпоративным ИИ сейчас. Какие обещания даёт рынок, и с чем в реальности сталкивается крупная компания, пытаясь их реализовать.
- Глава 3 — какие ключевые вопросы должна закрыть любая стратегия внедрения ИИ. Это чек-лист, по которому проверяется зрелость подхода.
- Глава 4 — целевая архитектура. Единый ИИ-слой между корпоративными системами и бизнес-сценариями: как он устроен и что должен уметь.
- Глава 5 — что должна получить компания от зрелого ИИ-слоя. Эффекты бизнеса и эффекты ИТ-блока — почему их нужно планировать одновременно.
- Глава 6 — конвейер ИИ-инициатив. Как идея бизнеса проходит путь до промышленной эксплуатации, и почему это управляемый процесс, а не «начнём — посмотрим».
- Глава 7 — метрики зрелости. Чек-лист самодиагностики: где компания находится сейчас, куда расти.
- Глава 8 — реализация. Корпоративная ИИ-платформа «Камерата», которая закрывает целевую архитектуру: как устроена, какие сценарии покрывает, какой технический контур обеспечивает. С этой главы начинается часть II.
- Глава 9 — AI Guard. Единый периметр безопасности корпоративного ИИ: маршрут одного запроса, многоуровневая защита, интеграция и эксплуатация.
- Глава 10 — Внешний офис ИИ. Формат прикладной инженерной команды на срок: одиннадцать ролей в четырёх фазах и то, какая роль уместна на каком уровне зрелости.
- Глава 11 — обучение и стратегические сессии. Три уровня обучения по карте зрелости, семь форматов и условия, при которых обучение меняет практику.
- Глава 12 — синтез. Четыре практики как система, карта выбора стартовой точки для семи типовых ситуаций и первый шаг.
Документ можно читать от начала до конца как связный материал, либо по главам — каждая из них самостоятельна и снабжена внутренними связями с остальными.
Глава 2
Реальность корпоративного ИИ сегодня
В этой главе мы фиксируем диагноз: что обещает индустрия и с чем в действительности сталкивается крупная компания, пытаясь это внедрить. Без этого диагноза любая стратегия выглядит абстрактной — а нам важно понимать, какие именно проблемы мы пытаемся решить системно в последующих главах.
2.1. Картинка, которую все продают
На профильных конференциях, в маркетинговых материалах вендоров, в обзорах консалтинговых компаний и в постах в социальных сетях складывается одна и та же картина: внедрение ИИ — это быстро, недорого и легко. По итогам последних двух лет в корпоративный обиход прочно вошёл набор обещаний, которые звучат примерно одинаково у разных продавцов:
«Внедрите ИИ за месяц — мы покажем эффект на пилоте уже к концу первого спринта.»
«Сократите расходы на персонал в три раза — ИИ закроет рутинные задачи, освободит людей для творческой работы.»
«Поставьте корпоративный Copilot — и ваши команды станут работать в два раза быстрее уже на следующей неделе.»
«Подключите ChatGPT API — и у вас будет полноценный корпоративный ИИ, способный отвечать на любые вопросы.»
«LLM ответит на любой вопрос по вашим корпоративным данным — достаточно просто загрузить документы.»
«ИИ-агенты заменят половину офисных задач уже в ближайший год — компании, которые не успеют, проиграют конкуренцию.»
В этих формулировках есть зерно правды — ИИ действительно радикально меняет способы работы, и компании, которые научатся пользоваться им быстрее, получат серьёзное преимущество. Но та форма, в которой это обещание подаётся, создаёт у заказчика опасное впечатление: ИИ — это покупка, а не инженерный проект. Подключил API, поставил ассистента, дал доступ команде — и эффект получен.
В реальности крупной компании всё устроено иначе. Между «подключить API» и «получить производственный эффект» лежит несколько уровней инфраструктурной, методологической и организационной работы, о которой на конференциях говорят редко — потому что эта работа не продаётся одной строчкой в коммерческом предложении и не помещается на красивый слайд.
2.2. Реальность крупной компании
Когда крупная компания пытается воспроизвести у себя то, что обещают рекламные материалы, обычно происходит шесть характерных историй. Они почти всегда возникают параллельно, накладываются друг на друга и в совокупности срывают сроки, бюджеты и ожидания. Ниже — обзор каждой из них.
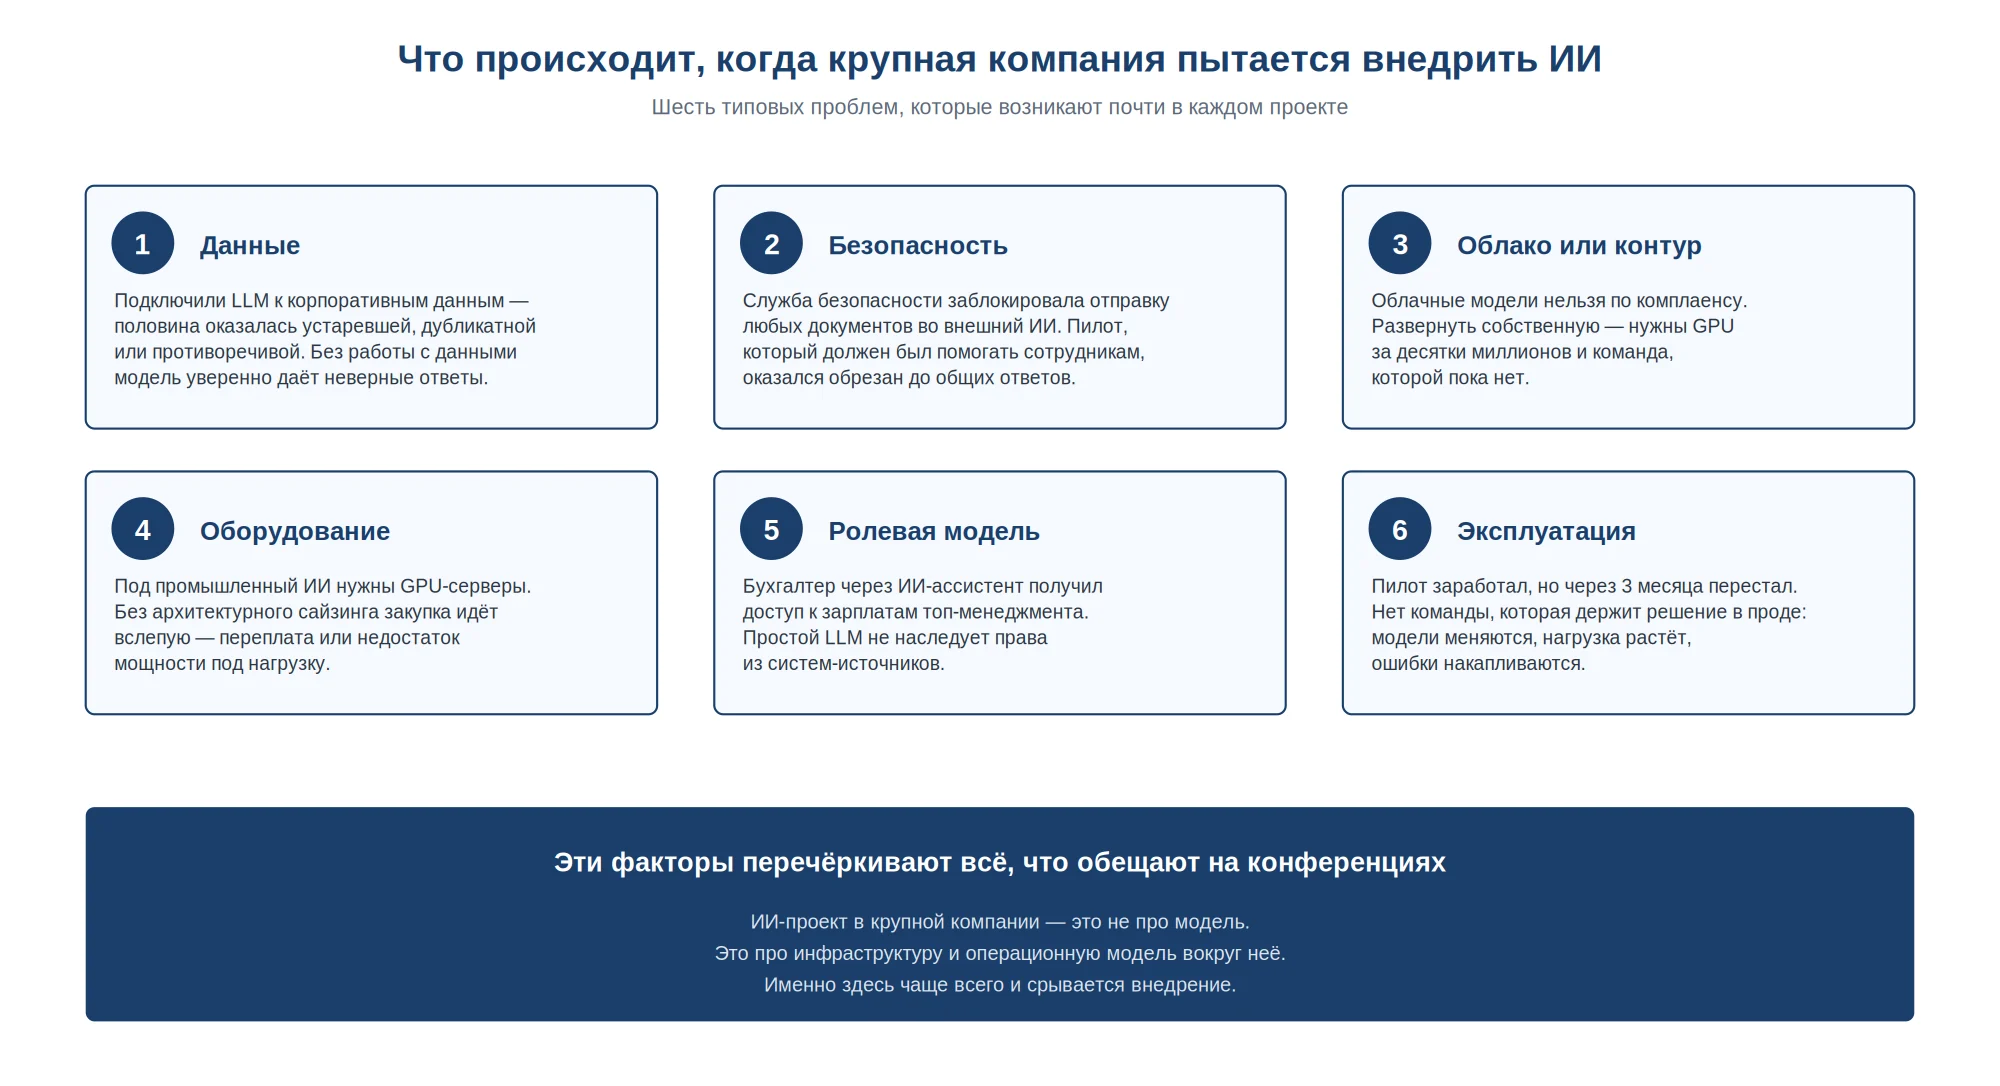
Проблема 1. Данные оказались не такими, как ожидалось
Это самая частая и самая недооценённая проблема. Когда LLM подключают к корпоративным данным, выясняется: половина из них устарела, дублируется в нескольких системах, противоречит сама себе, не имеет владельца. Модель, опирающаяся на такие данные, начинает с уверенным видом выдавать неверные ответы — и доверие к проекту разрушается с первой же демонстрации руководству.
Корень этой проблемы в том, что в корпоративном ИТ-ландшафте «данные» — это не одна таблица, а десятки систем, накопленных за двадцать лет: ERP, CRM, BPM, DWH, файловые хранилища, переписки, документы в форматах разной степени структурированности. Никакая модель сама не разберётся, какая запись актуальна, а какая — устаревший черновик. Эту работу нужно проделывать инженерно — выстраивать каталог, lineage, политики актуальности, разрешения. Без этого ИИ работает на мусоре и даёт мусор.
Проблема 2. Служба безопасности не пропускает данные за периметр
После того, как первый энтузиазм проходит, в проект приходит ИБ-блок. И задаёт прямой вопрос: какие данные мы отправляем во внешнюю модель? Если ответ — «все, что выберет пользователь» — пилот блокируется или обрезается до общих ответов, которые не имеют отношения к корпоративному контексту.
Это не блажь безопасников. В корпоративных документах хранятся персональные данные, коммерческая тайна, исходный код, внутренняя переписка, договорные условия — то, что по закону или по политике компании не должно покидать периметр без специальных мер защиты. Когда в архитектуре проекта эти меры не предусмотрены, ИБ-блок оказывается в позиции «либо запретить, либо взять на себя риск утечки». Закономерно выбирается первое.
Проблема 3. Облачные модели нельзя, on-prem требует инвестиций
Эта развилка возникает практически в любом проекте корпоративного ИИ. Облачные модели — это самый простой и быстрый способ получить высокое качество ответов. Но в большинстве крупных российских компаний — по требованиям регулятора, по политике безопасности, по специфике отрасли — отправлять корпоративные данные в зарубежное облако запрещено. Часть задач можно решить через российские облачные LLM, но не все: для критически важных контуров, для работы с персональными данными, для систем с особыми требованиями к комплаенсу — нужен on-premise.
On-premise, в свою очередь, требует инвестиций. Это GPU-серверы стоимостью в десятки миллионов рублей, инфраструктура их размещения и охлаждения, команда поддержки, лицензии и подписки на модели. Принять решение об этих инвестициях без архитектурной оценки — означает идти вслепую. Принять решение «давайте подождём, пока всё подешевеет» — означает отставать от рынка.
Проблема 4. Оборудование закупается без сайзинга
Связанная с предыдущей, но самостоятельная проблема. Под промышленный ИИ нужны GPU-серверы. Без архитектурной оценки нагрузки — числа пользователей, частоты запросов, длины контекста, требований к latency — закупка идёт «по аналогии» или «с запасом». Результат: либо переплата за мощности, которые не используются, либо нехватка мощностей в момент, когда сценарии начинают масштабироваться.
Архитектурный сайзинг — это не разовая оценка перед закупкой. Это процесс, который встроен в работу платформы: мониторинг утилизации, прогноз роста нагрузки, рекомендации по докупке. Если этого процесса нет — компания либо живёт с проблемой «модели тормозят, пользователи жалуются», либо вкладывается в инфраструктуру, которая стоит больше, чем нужно.
Проблема 5. Простая LLM не наследует ролевую модель
Самая болезненная история возникает, когда корпоративный ИИ подключают к нескольким системам одновременно — к ERP, к HR, к CRM, к документам. Сотрудник, у которого в обычной работе доступ только к собственному отделу, через ИИ-ассистент получает ответы, содержащие данные из всей компании — потому что модель смотрит на все источники одинаково.
Классический пример: бухгалтер задаёт ассистенту общий вопрос по компании — а в ответе оказываются зарплаты топ-менеджмента, которые он не должен был видеть. С этого момента ассистент превращается из инструмента продуктивности в источник риска. Решение этой проблемы — отдельный архитектурный уровень: ролевая модель должна наследоваться из систем-источников, фильтрация по правам должна происходить до того, как данные дойдут до модели, доступ к каждому запросу должен быть аудируем.
Проблема 6. Пилот заработал, но его некому держать в проде
Это история про эксплуатацию — самую недооценённую часть ИИ-проекта. Пилот часто делается силами команды, которая загорелась идеей, собрала прототип, показала эффект. Через два-три месяца после запуска эта команда переходит к следующему проекту. А пилот тем временем начинает деградировать: модели на стороне провайдера меняются — изменяется поведение системы; объём данных растёт — растут счета и время ответа; в логах накапливаются ошибки, которые никто не разбирает; пользователи теряют доверие.
Через полгода такой пилот незаметно перестаёт использоваться — а компания делает вывод «ИИ не работает». На самом деле работает — но эксплуатация ИИ-системы требует выделенной команды, регламентов, метрик качества, процедур обновления и инцидент-менеджмента. Если этого нет на старте — проект обречён, независимо от того, насколько хороши были модель и пилот.
2.3. Что это значит
Шесть описанных историй — не редкие отклонения, а типовая картина. Они возникают почти в каждом проекте корпоративного ИИ просто потому, что эти проекты не отличаются по природе от других сложных корпоративных внедрений: они требуют работы с данными, с безопасностью, с инфраструктурой, с ролями, с эксплуатацией. Только в случае ИИ эта работа особенно недооценивается — потому что фокус публичной дискуссии прикован к моделям, а не к контуру вокруг них.
Из этого следует главный вывод, который мы хотим зафиксировать в самом начале документа:
Если согласиться с этим тезисом, то логика дальнейшего разговора меняется. Вопрос «какую модель выбрать» уступает место вопросу «как должна быть устроена архитектура, чтобы любые модели — текущие и будущие — встраивались в неё управляемо». Вопрос «можно ли запустить пилот за месяц» уступает место вопросу «как сделать пилот так, чтобы он стал первым шагом промышленного решения, а не одноразовой демонстрацией». Вопрос «сколько это стоит» уступает место вопросу «во что мы инвестируем — в инструмент или в платформу, которая обеспечит десятки сценариев».
Именно эти вопросы — что должна закрыть стратегия внедрения, как устроена правильная архитектура, что должна получить компания от зрелого ИИ-слоя — мы разворачиваем в следующих главах.
Глава 3
Ключевые вопросы внедрения
В предыдущей главе мы зафиксировали, что ИИ-проект в крупной компании — это не про модель, а про инфраструктуру и операционную модель вокруг неё. В этой главе мы переводим это утверждение в практическую плоскость: какие именно вопросы должна закрывать любая стратегия внедрения. Это чек-лист, по которому проверяется зрелость подхода — собственной разработки, готовой платформы или работы с внешней командой.
3.1. Зачем нужен чек-лист
Шесть проблем, которые мы описали в предыдущей главе, возникают не случайно. За каждой из них стоит конкретный вопрос — инженерный, методологический или организационный — на который компания не успела ответить до старта проекта. Когда стратегии внедрения нет, эти вопросы возникают по ходу: сначала «давайте подключим LLM», потом «оказалось, что данные не такие», потом «безопасность не пропускает», потом «нужно железо», потом «кто будет это поддерживать». Каждый шаг требует возврата к началу и пересмотра уже сделанного — и проект превращается в бесконечную серию переделок.
Когда стратегия есть, эти вопросы задаются один раз — на старте. Ответы фиксируются, превращаются в архитектурные решения, в бюджет, в роли в команде, в этапы внедрения. Дальше работа идёт по плану. Это базовая разница между зрелым корпоративным подходом и хаотичной чередой пилотов: вопросы не уходят, они либо задаются заранее, либо возникают по факту — и срывают проект.
В этой главе мы перечисляем восемь вопросов, которые, по нашему опыту, исчерпывающе закрывают типовую повестку внедрения. Любой подход — будь то собственная разработка корпоративного ИИ-слоя, лицензирование готовой платформы или привлечение внешней инженерной команды — должен закрывать каждый из этих вопросов. Если на какой-то вопрос нет ответа — это будущая точка отказа, и обычно проект встаёт именно там, где когда-то было сказано «потом разберёмся».
3.2. Восемь вопросов, которые должна закрыть стратегия внедрения
Ниже — обзор каждого вопроса с пояснением, что за ним стоит и почему он критичен. Порядок следования не означает приоритетности: вопросы должны решаться параллельно, поскольку они тесно связаны между собой.
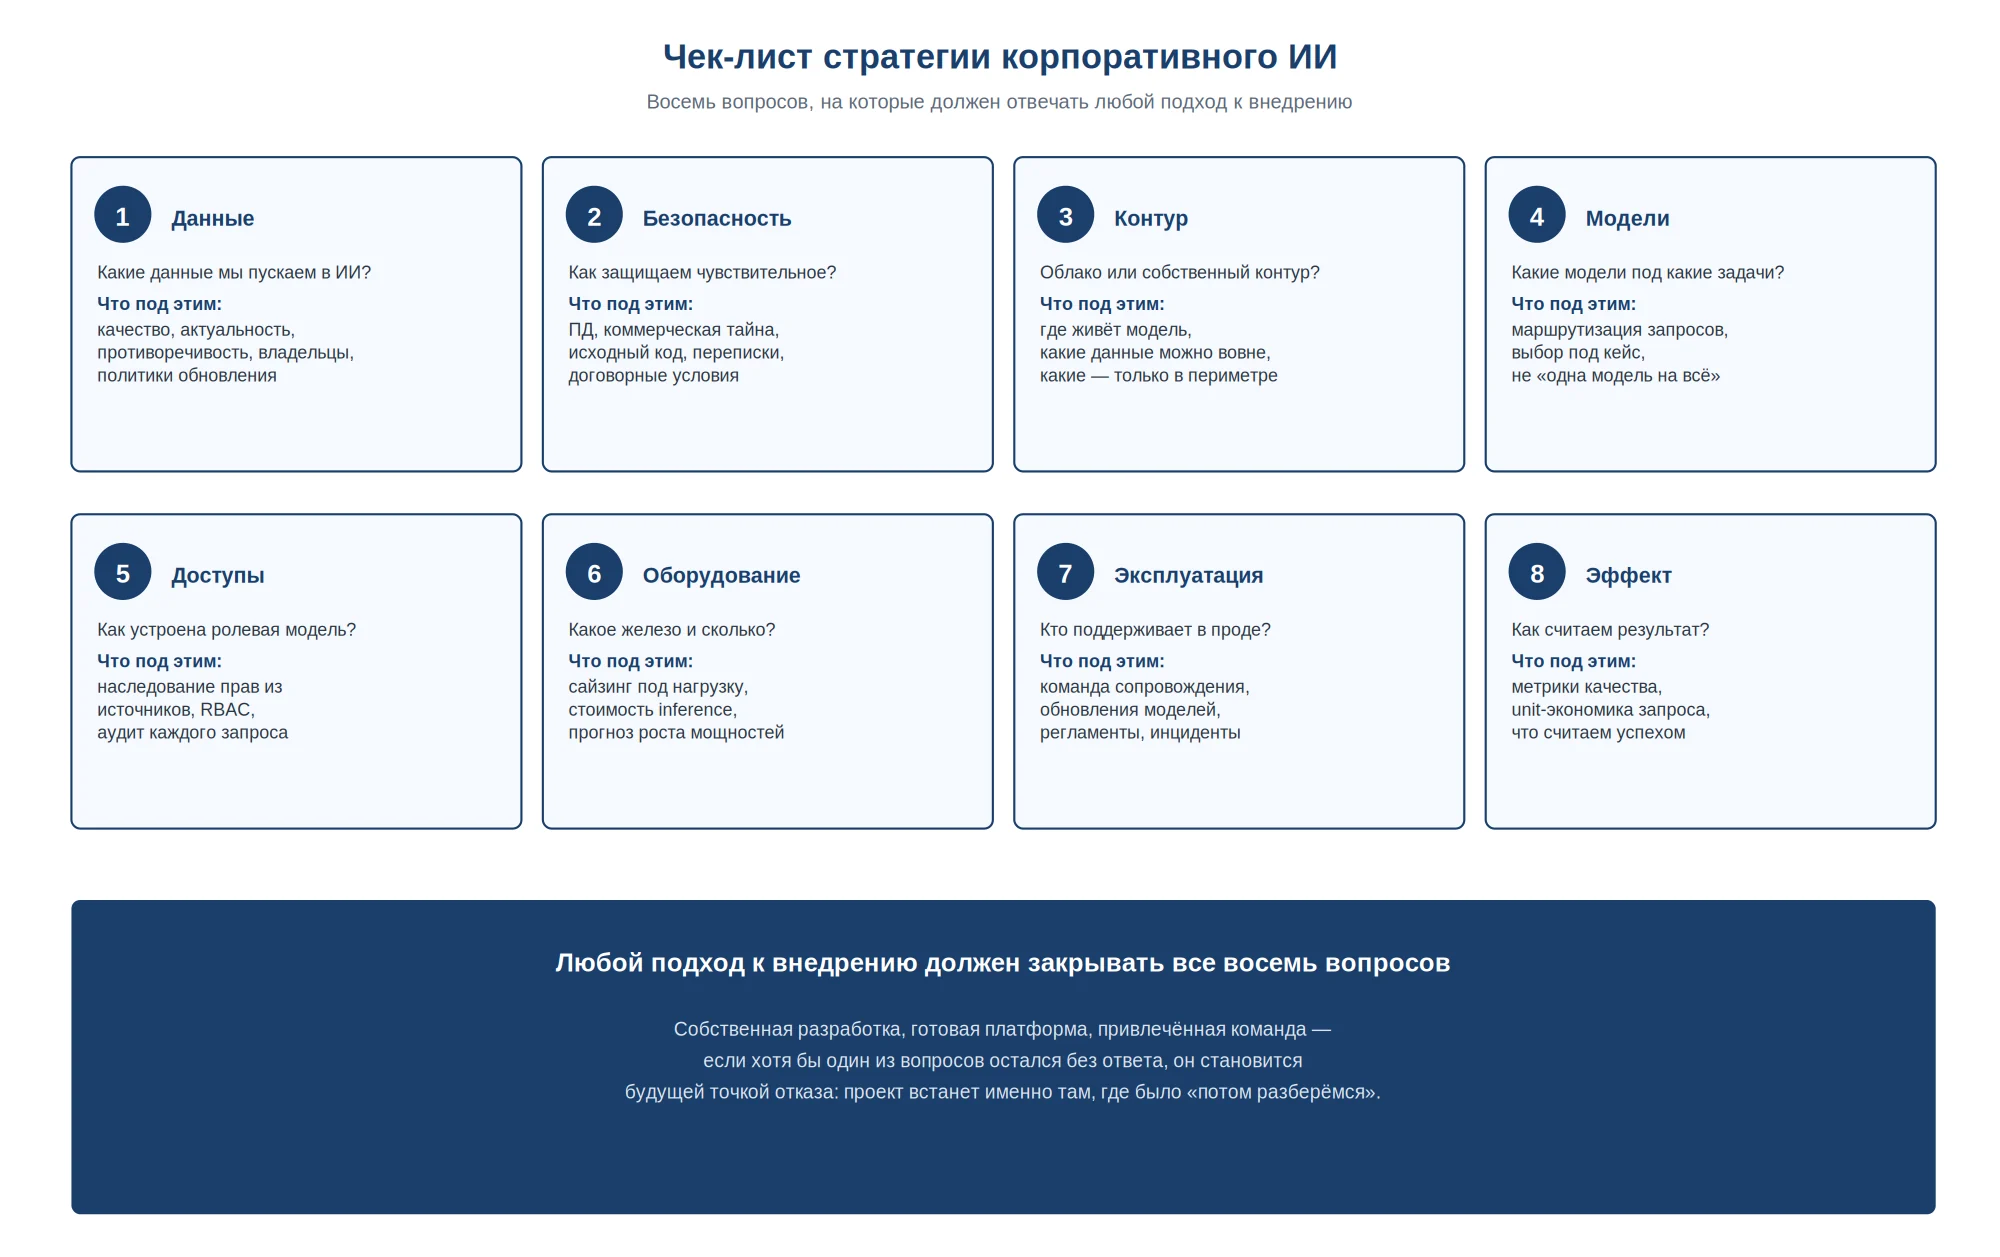
Вопрос 1. Какие данные мы пускаем в ИИ?
Этот вопрос определяет всё остальное. Когда мы говорим «корпоративный ИИ», первое, что нужно понять, — на какие данные он будет опираться. Это касается и структурированных источников (ERP, CRM, DWH), и неструктурированных (документы, регламенты, переписки). Для каждого источника нужно ответить: насколько данные актуальны, кто их владелец, какие политики обновления, какие противоречия между источниками известны, как разрешается приоритет в случае конфликтов.
Если ответа нет — модель работает на данных вслепую. Сценарий, который красиво выглядит на пилоте, перестаёт быть надёжным, как только пользователи начинают задавать сложные межсистемные вопросы. На демо это незаметно, в эксплуатации — становится главной причиной потери доверия к ИИ-системе.
Вопрос 2. Как защищаем чувствительное?
Какие данные классифицируются как чувствительные: персональные данные сотрудников и клиентов, коммерческая тайна, исходный код, внутренняя переписка, договорные условия. Какие меры защиты применяются: маскирование, токенизация, обезличивание, шифрование, контроль трафика наружу. Какие политики для каких типов данных — что можно отправлять в облачные LLM, что — только в локальную модель, что — никогда.
Это вопрос, который в крупной компании невозможно решить силами одной ИТ-команды. Здесь нужен совместный ответ ИТ, ИБ, юридического блока, а иногда и регулятора. Без него ИБ-блок справедливо блокирует любую интеграцию с ИИ — и это не «препятствие развитию», а защита компании от рисков, которые в случае утечки оказываются дороже всего эффекта от ИИ.
Вопрос 3. Облако или собственный контур?
Этот вопрос на самом деле составной. Не «либо–либо», а «где какие задачи». Часть сценариев допускает работу с облачными моделями: внутренние ассистенты, не работающие с ПД и тайной; маркетинговые задачи; обучающие материалы. Часть сценариев — только в локальном контуре: всё, что связано с персональными данными клиентов и сотрудников; всё, что касается финансовых операций; всё, что регулируется специальными требованиями.
Правильный ответ — гибридная стратегия с чёткими политиками маршрутизации: для каждого типа задачи и каждого типа данных определено, в каком контуре они обрабатываются. Это сложно организовать на старте, но именно это позволяет использовать сильные стороны облачных моделей там, где можно, и сохранять контроль там, где обязательно.
Вопрос 4. Какие модели под какие задачи?
Это вопрос инженерной маршрутизации. Современная ИИ-инфраструктура — это не одна модель, отвечающая на все запросы. Это набор моделей разного размера, специализации и стоимости, между которыми идёт интеллектуальная маршрутизация. Простой вопрос идёт на дешёвую быструю модель. Сложный аналитический — на более мощную. Чувствительный — на локальную. Запрос про код — на специализированную.
Если стратегии маршрутизации нет, компания работает по принципу «одна модель на всё» — обычно самая мощная и самая дорогая. Это означает, что простые задачи стоят в десятки раз дороже, чем должны, а специфичные задачи решаются хуже, чем могли бы. Архитектурное решение здесь — единый AI Gateway, через который проходят все запросы и который делает выбор модели прозрачным для прикладного кода.
Вопрос 5. Как устроена ролевая модель?
Самый недооценённый, но один из самых критичных вопросов. Когда сотрудник обращается к ИИ-ассистенту, он не должен получать данные, к которым у него нет доступа в исходных системах. Это означает, что ролевая модель ИИ не может быть «нарисована заново» — она должна наследоваться из систем-источников. Если в CRM у менеджера доступ только к собственным клиентам — то и через ИИ-ассистент он должен видеть только их. Если в HR-системе зарплаты топ-менеджмента закрыты для рядовых сотрудников — модель не должна их раскрывать никогда, ни в каком виде.
Технически это решается на уровне ИИ-слоя: фильтрация данных по правам происходит до того, как они попадают в контекст модели. Каждый запрос аудируется. Каждый ответ можно проверить — на каких данных он построен и были ли у пользователя права на них. Без этой инфраструктуры любая интеграция ИИ с корпоративными системами становится потенциальным источником раскрытия данных, и это рано или поздно произойдёт.
Вопрос 6. Какое оборудование и сколько?
Если выбран собственный контур, нужен сайзинг. Сколько GPU-серверов, какой памяти, какой производительности. Под какую нагрузку — количество одновременных пользователей, средняя длина контекста, требования к latency, частота запросов в пик. Какой запас на рост — потому что, когда сценарии заработают, нагрузка вырастет в разы за несколько месяцев.
Эта оценка не делается один раз перед закупкой. Это процесс, который встроен в работу платформы: мониторинг утилизации, прогноз роста, рекомендации по расширению. Если этого процесса нет — компания либо переплачивает за неиспользуемые мощности, либо упирается в потолок производительности именно тогда, когда ИИ-сценарии начинают давать наибольший эффект.
Вопрос 7. Кто поддерживает в проде?
ИИ-системы требуют отдельной эксплуатации. Это не «как обычный микросервис» — это система, в которой постоянно меняются модели на стороне провайдеров, изменяется поведение от версии к версии, дрейфует качество ответов, накапливаются ошибки. Кто отвечает за обновления моделей? Кто разбирает инциденты с неправильными ответами? Кто следит за метриками качества? Кто принимает решение о смене провайдера, если он повышает цены или ухудшает качество? Кто проводит регрессионное тестирование при обновлении моделей?
Если эти роли не определены — пилот работает первые месяцы по инерции, а потом начинает деградировать. Через полгода ИИ-сервис незаметно перестаёт использоваться, и компания делает вывод «ИИ не работает». На самом деле работает — но эксплуатация ИИ-системы требует выделенной команды, регламентов и процессов, которых на старте, как правило, не предусматривают.
Вопрос 8. Как считаем результат?
Финальный вопрос — без которого все остальные превращаются в технические упражнения. Что считаем успехом ИИ-проекта? Что измеряем — экономию времени сотрудников, ускорение принятия решений, рост NPS клиентов, снижение затрат на обработку обращений? Как переводим эти метрики в деньги? Какая unit-экономика одного запроса — сколько стоит сценарий в пересчёте на пользователя или на операцию? Когда сценарий считается окупившимся?
Если этих метрик нет на старте, проект превращается в «давайте посмотрим, что получится». Через полгода руководству невозможно объяснить, что именно дал ИИ. Если же метрики определены — становится возможным управлять портфелем ИИ-инициатив осознанно: видеть, какие сценарии дают эффект, какие — нет, куда стоит инвестировать дополнительные ресурсы, а какие проекты лучше остановить.
3.3. Что значит, если на вопрос нет ответа
Не на все восемь вопросов компания должна иметь готовый ответ в момент старта работы с ИИ — некоторые ответы формируются в процессе. Но на каждый вопрос должна быть либо позиция, либо план её выработки. Если вопрос игнорируется — он не исчезает, он откладывается и возникает позже, когда менять решения сложнее и дороже.
По нашему опыту, типовая ошибка — игнорировать вопросы 5, 7 и 8 (ролевая модель, эксплуатация и метрики эффекта). Они кажутся «организационными», в то время как «технические» вопросы (модели, оборудование, контур) выглядят более срочными. На практике именно отсутствие ответов на «организационные» вопросы чаще всего убивает проекты. Технические препятствия в крупной компании, как правило, решаются. Организационные — копятся и в какой-то момент делают проект невозможным.
Из всех восьми вопросов вытекает следующий тезис. Если ответы должны быть системными, переиспользуемыми и масштабируемыми — значит, для них нужна общая инфраструктура. Не отдельный продукт под каждый сценарий, а единая платформа, через которую решаются все ИИ-задачи компании. Именно эту мысль мы разворачиваем в следующей главе.
Глава 4
Целевая архитектура: ИИ-слой как ядро
Восемь вопросов из предыдущей главы — это диагностическая часть нашего подхода. Эта глава — конструктивная: мы описываем целевое состояние корпоративной ИИ-инфраструктуры. Это не описание конкретного продукта, а изложение принципа, который, по нашему опыту, единственный позволяет внедрять и развивать ИИ-сценарии в крупной компании управляемо. Принцип не зависит от инструмента; наша реализация описана во второй части, начиная с главы 8.
4.1. От набора задач к единой инфраструктуре
Если задать восемь вопросов из предыдущей главы и попытаться ответить на них по отдельности для каждого ИИ-сценария — компания получает зоопарк. Один отдел подключил ChatGPT через прокси. Второй купил готового ИИ-ассистента. Третий заказал у подрядчика чат-бот по своей базе. Четвёртый интегрировал ИИ в свой CRM. Каждое решение работает само по себе, но в совокупности компания имеет десяток разных контуров безопасности, разрозненные политики доступа, неконтролируемые расходы на inference, никаких метрик качества и никакой общей картины — что и где используется.
Через год эта картина становится неуправляемой. Появляется проект «инвентаризация ИИ» — попытка понять, что вообще у нас работает. Появляется потребность централизовать безопасность — потому что разные сценарии используют разные политики, а ИБ-блок не может это контролировать. Появляется потребность централизовать расходы — потому что суммарный счёт растёт быстрее, чем эффект. И в итоге компания приходит к тому, с чего разумно было начать: к единому ИИ-слою.
Единый ИИ-слой — это инженерная инфраструктура между корпоративными системами и бизнес-сценариями. Это не «ещё один продукт». Это уровень архитектуры компании, через который решаются все задачи, связанные с ИИ. Решение по архитектуре принимается один раз. Дальше любой новый сценарий запускается не как отдельный проект, а как ещё одно прикладное применение уже существующего слоя.
4.2. Принцип единого слоя
Архитектурно ИИ-слой располагается между двумя классами систем: с одной стороны — корпоративные источники данных и приложения (ERP, CRM, BPM, DWH, документы, прочие APIs), с другой стороны — бизнес-сценарии, для которых нужен ИИ (агенты, ассистенты, аналитические интерфейсы, автоматизация процессов). Все ИИ-запросы проходят через слой, все интеграции с корпоративными системами — через него же.
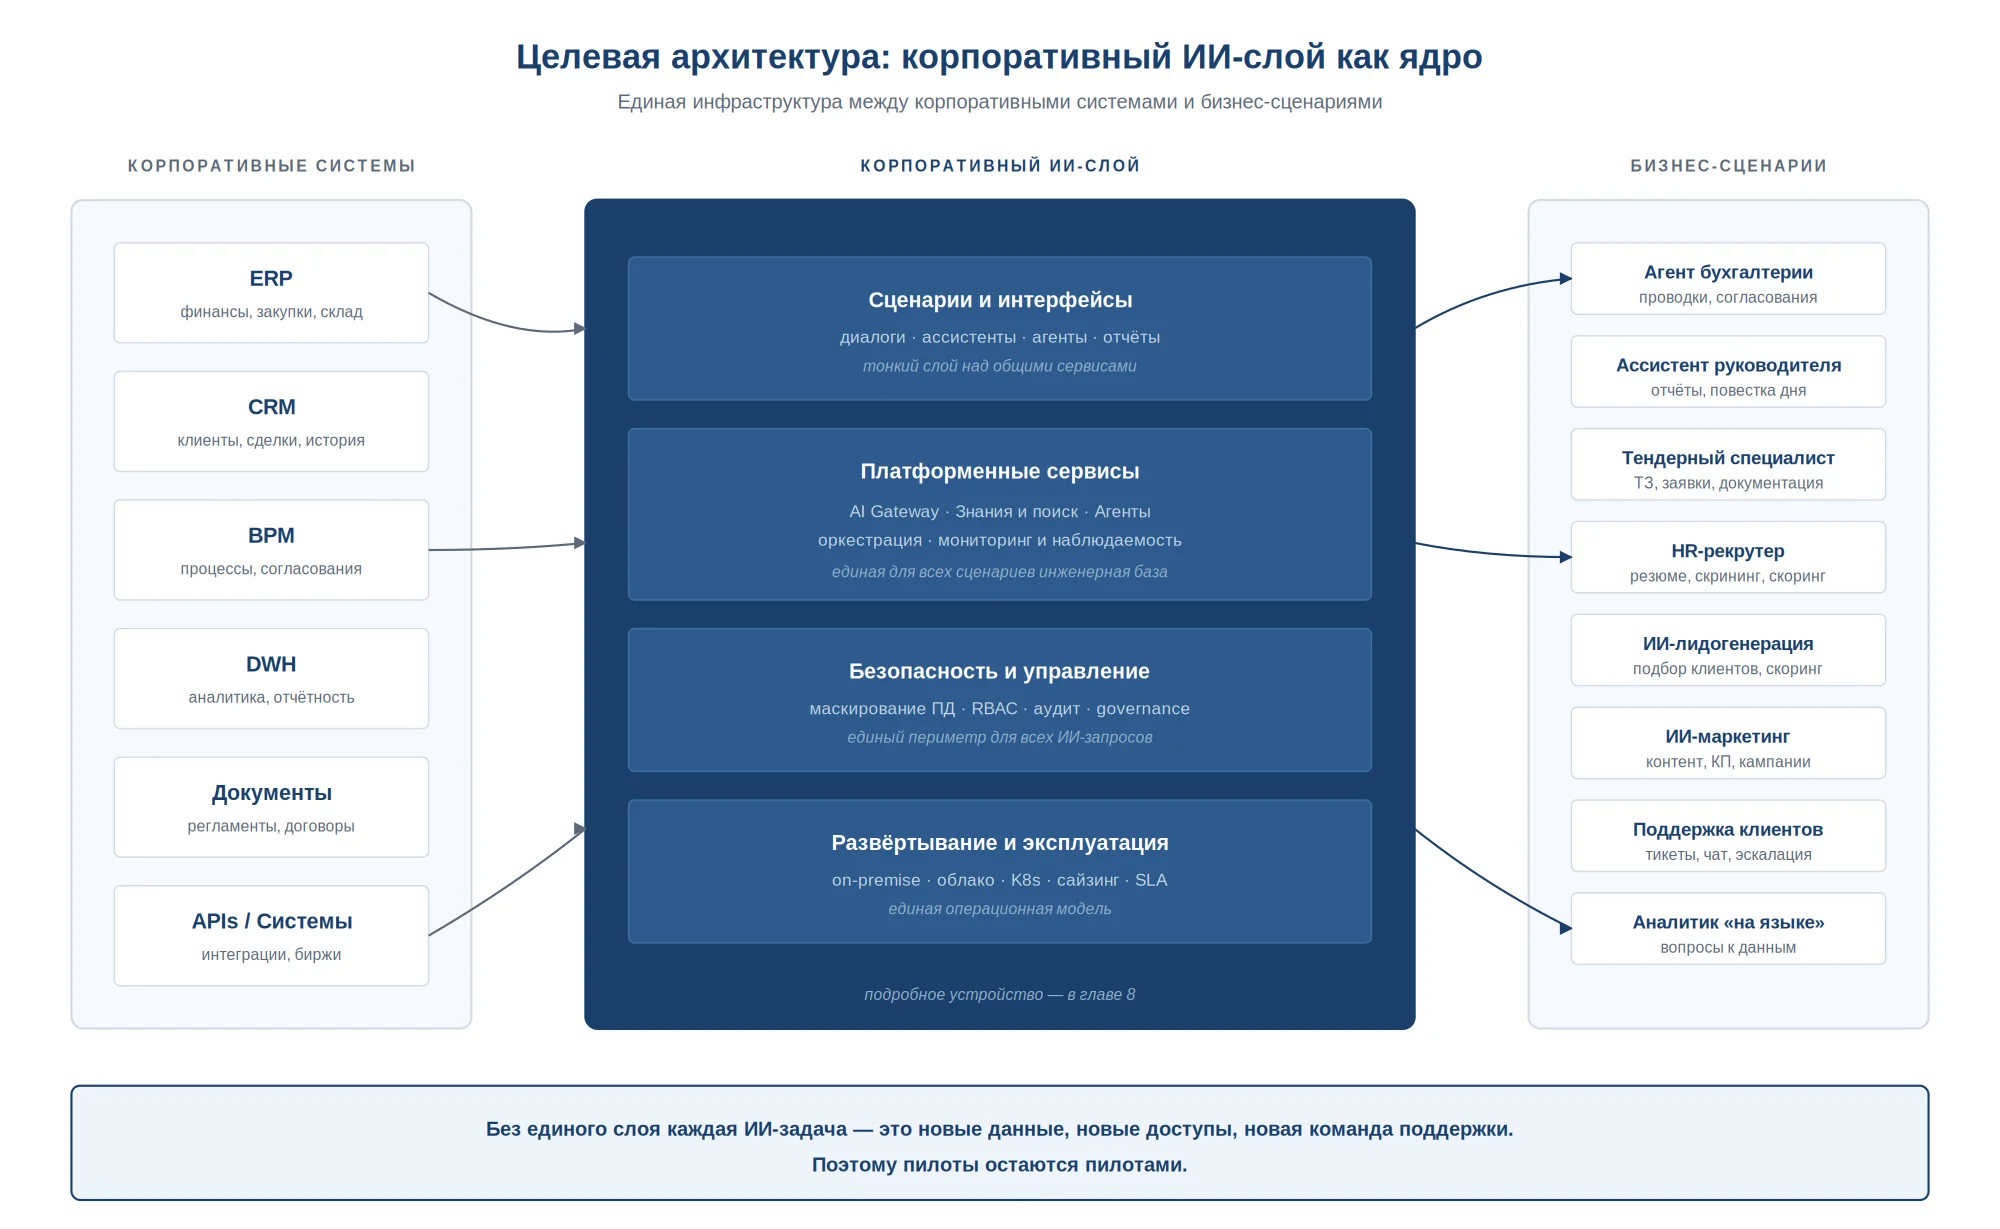
Логика устройства
Слева — корпоративный ИТ-ландшафт. Это то, что в компании уже есть: системы учёта, документооборот, базы знаний, хранилища данных. Эти системы продолжают работать в своей обычной роли — ИИ-слой не заменяет их, а становится для них новым типом потребителя.
В центре — корпоративный ИИ-слой. Он не однородный — внутри него несколько функциональных областей. Сценарии и интерфейсы — тонкий верхний уровень, на котором живут конкретные ИИ-приложения (диалоги, ассистенты, агенты, отчёты). Платформенные сервисы — общая инженерная база (маршрутизация моделей, корпоративный поиск, оркестрация агентов, мониторинг). Безопасность и управление — единый периметр для всех ИИ-запросов (маскирование ПД, контроль доступа, аудит, governance). Развёртывание и эксплуатация — операционный фундамент (выбор контура, сайзинг, масштабирование, SLA). Подробное устройство каждого из этих уровней — в главе 8.
Справа — бизнес-сценарии. Это то, ради чего слой строится. ИИ-агент бухгалтерии, ассистент руководителя, тендерный специалист, HR-рекрутер, ИИ-лидогенерация, маркетинговые помощники, поддержка клиентов, аналитик «на естественном языке». Каждый сценарий — это не отдельный проект с нуля, а композиция уже существующих в слое возможностей.
Почему слой, а не отдельные продукты под каждую задачу
Принципиальная разница между подходом «единый слой» и подходом «отдельный продукт под каждый сценарий» — в стоимости и времени запуска N-го сценария. В подходе «отдельный продукт» эта стоимость постоянна или растёт: каждое следующее решение требует своих данных, своих доступов, своей команды поддержки, своего ИБ-аудита. В подходе «единый слой» — стоимость новых сценариев падает, потому что общая инфраструктура уже построена: для нового сценария нужно описать его специфику, а вся базовая обвязка (безопасность, мониторинг, маршрутизация, развёртывание) уже работает.
Это означает важную вещь: единый ИИ-слой имеет смысл, если компания планирует не один-два, а несколько десятков ИИ-сценариев в течение нескольких лет. Если компания строит один пилот «попробовать ИИ» — отдельный продукт обойдётся дешевле в моменте. Если компания всерьёз меняет свою операционную модель с помощью ИИ — то без слоя количество сценариев упрётся в пять-десять и дальше расти не будет, потому что управлять зоопарком станет невозможно.
4.3. Что должен уметь ИИ-слой
Если согласиться, что инфраструктура должна быть единой, возникает следующий вопрос: какие именно инженерные возможности должна предоставлять эта инфраструктура. Это не «фичи продукта», а классы инженерных задач, которые компания решает раз и навсегда — после чего может масштабировать применение ИИ без возврата к этим задачам в каждом новом сценарии.
По нашему опыту, исчерпывающий минимум — шесть инженерных возможностей. Каждая из них прямо отвечает на один или несколько вопросов из чек-листа третьей главы. То есть набор возможностей — не произвольный список, а отражение тех самых вопросов, которые мы зафиксировали как обязательные для зрелой стратегии внедрения.
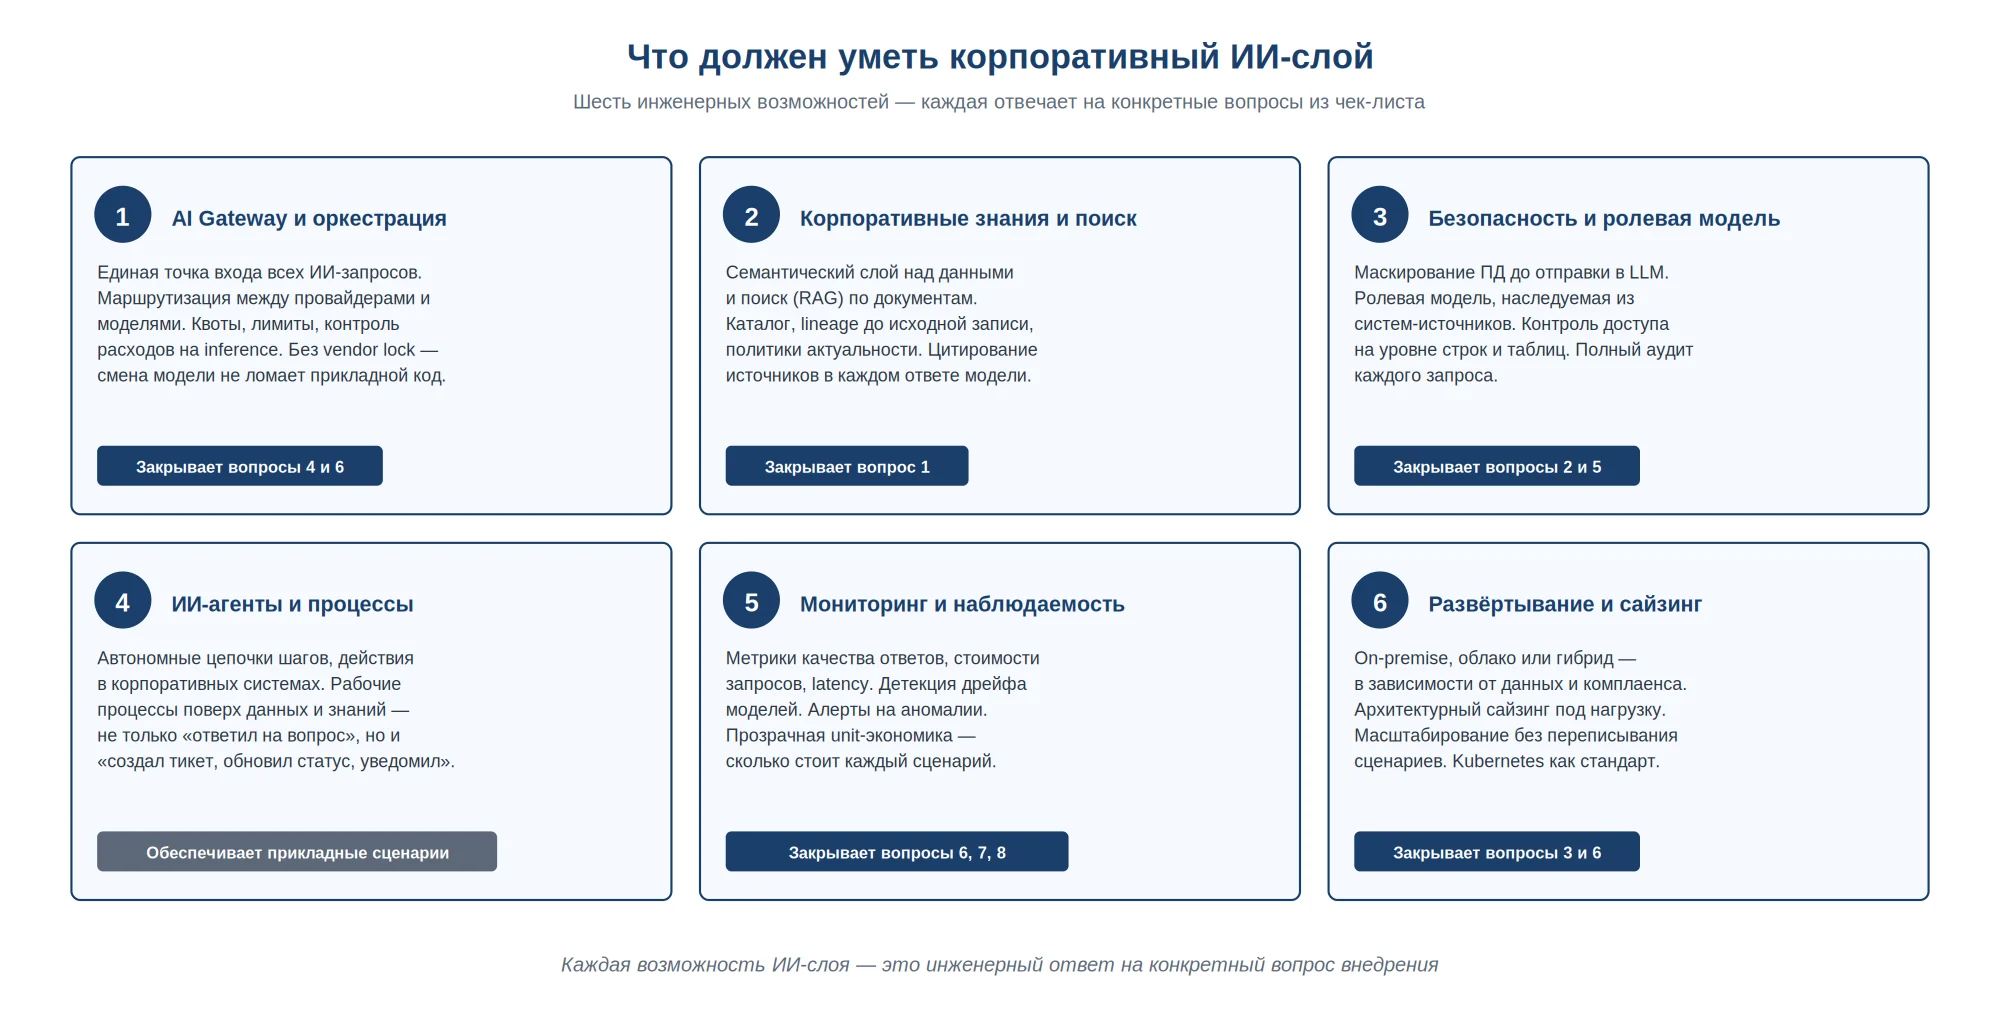
Возможность 1. AI Gateway и оркестрация
Единая точка входа для всех ИИ-запросов компании. Через шлюз проходит каждое обращение к модели — независимо от того, какое приложение его инициировало и в каком отделе работает пользователь. На этом уровне решается выбор модели под задачу: простой вопрос отправляется на быструю и дешёвую модель, сложный аналитический — на мощную, чувствительный — на локальную. Здесь же контролируются квоты на пользователя, на отдел, на сценарий — что не даёт расходам на inference расти бесконтрольно. Здесь же реализуется политика без vendor lock: смена провайдера или модели не требует переписывания прикладного кода — все приложения говорят с шлюзом одним интерфейсом, а маршрутизация спрятана внутри.
Это возможность, которая закрывает вопросы 4 (выбор моделей под задачи) и 6 (контроль стоимости оборудования и inference). Без шлюза каждое приложение реализует выбор моделей и квоты самостоятельно — и компания теряет общее представление о том, что у неё происходит.
Возможность 2. Корпоративные знания и поиск
Этот уровень отвечает за то, чтобы модель работала с реальными данными компании, а не с тем, что было в её обучающей выборке. Семантический слой над данными обеспечивает единый язык понятий: что в этой компании называется выручкой, как считается прибыль, как определяется клиент. Корпоративный поиск (RAG) — это инфраструктура для работы с документами: регламентами, договорами, перепиской, презентациями. Каталог данных описывает, какие источники есть, кто их владелец, какие политики применяются. Lineage до исходной записи позволяет в каждом ответе модели сказать, на каких именно данных он построен.
Цитирование источников — обязательный элемент. Корпоративный ИИ не должен «угадывать», он должен ссылаться на источник. Это закрывает вопрос 1 (данные) — самый частый и самый критичный из всех. Без этой возможности ИИ-ассистенты в крупной компании быстро теряют доверие пользователей, потому что начинают давать ответы, которые невозможно проверить.
Возможность 3. Безопасность и ролевая модель
Уровень, который превращает ИИ из риска в управляемый инструмент. Маскирование персональных данных происходит до того, как запрос покидает периметр компании или попадает в LLM. Ролевая модель наследуется из систем-источников: если у пользователя нет прав на данные в исходной системе, он не получит их и через ИИ-ассистент. Контроль доступа реализуется не только на уровне приложений, но и на уровне строк и таблиц — нужный фильтр применяется автоматически в зависимости от того, кто задаёт вопрос. Каждый запрос аудируется: служба безопасности может в любой момент посмотреть, кто, когда, что спрашивал и какой ответ получил.
Эта возможность закрывает вопросы 2 (защита чувствительного) и 5 (ролевая модель). Без неё интеграция ИИ с корпоративными системами становится потенциальным каналом утечек — и ИБ-блок справедливо блокирует расширение использования. С ней — компания получает доказательную базу того, что ИИ работает в рамках корпоративных политик безопасности.
Возможность 4. ИИ-агенты и процессы
Этот уровень обеспечивает прикладные сценарии — то, что отличает корпоративный ИИ от «чат-бота, который умеет отвечать». Агенты — это автономные цепочки шагов, в которых ИИ не просто реагирует на вопрос, а выполняет последовательность действий: получить данные из системы, обработать их, принять решение, выполнить операцию в другой системе, уведомить пользователя. Это рабочие процессы поверх данных и знаний — где модель встроена как один из участников бизнес-процесса, а не как изолированный инструмент.
Эта возможность не закрывает какой-то один вопрос напрямую — она использует все остальные. Агенты опираются на знания (возможность 2), работают через шлюз (возможность 1), соблюдают безопасность (возможность 3), мониторятся (возможность 5), развёрнуты на инфраструктуре (возможность 6). Поэтому именно агенты — наиболее заметный для бизнеса элемент ИИ-слоя: они дают самый прямой и измеримый эффект, но требуют, чтобы все остальные уровни уже работали.
Возможность 5. Мониторинг и наблюдаемость
Уровень, без которого ИИ-система деградирует тихо. Метрики качества ответов — какой процент запросов получает релевантный ответ, как меняется этот процент со временем, не «дрейфует» ли модель после очередного обновления у провайдера. Метрики стоимости — сколько стоит средний запрос, как распределяются расходы между моделями, сценариями, пользователями. Метрики latency — насколько быстро отрабатывает каждый сценарий, не появились ли деградации. Алерты на аномалии — автоматическое уведомление, если что-то начинает отклоняться от нормы.
Эта возможность закрывает вопросы 6 (контроль стоимости), 7 (эксплуатация) и 8 (как считаем результат). Без неё ИИ-система работает «вслепую» — никто не знает, что именно происходит, до тех пор, пока пользователи не начинают массово жаловаться. С ней — компания получает прозрачную картину, которую можно показывать руководству и на основе которой можно управлять портфелем ИИ-инициатив.
Возможность 6. Развёртывание и сайзинг
Операционный фундамент ИИ-слоя. Развёртывание может быть на собственной инфраструктуре, в облаке, или в гибридной модели — выбор делается под каждый сценарий исходя из требований к данным и комплаенсу. Архитектурный сайзинг определяет, сколько мощностей нужно под текущую нагрузку и какой запас нужен на рост. Масштабирование происходит без переписывания прикладных сценариев — за счёт того, что они работают через единую инфраструктуру. Kubernetes как стандарт развёртывания — потому что это позволяет управлять контейнеризованными ИИ-сервисами одинаково, независимо от провайдера и места размещения.
Эта возможность закрывает вопросы 3 (контур) и 6 (оборудование). Без неё инфраструктурные решения принимаются ad hoc — отдельно под каждый сценарий, без общей политики. С ней — компания имеет единую операционную модель, в рамках которой новые сценарии запускаются на готовой инфраструктуре, а не требуют каждый раз нового цикла планирования и закупок.
4.4. Почему это инженерная инфраструктура, а не приложение
Корпоративный ИИ-слой принципиально отличается от приложения тем, что у него нет «своего пользователя» — он не используется напрямую. Им пользуются другие системы и сценарии. Это похоже на то, как в зрелой компании устроены интеграционная шина, корпоративное хранилище данных, единая система аутентификации: ими не пользуются «как продуктом», но без них компания не может работать в её нынешнем масштабе. В одиночку каждая такая инфраструктура не приносит немедленного эффекта — её ценность раскрывается в количестве сценариев, которые она обеспечивает.
Из этого следует несколько важных выводов для подхода к внедрению. Во-первых, инвестиции в ИИ-слой нельзя оценивать по эффекту от одного сценария — нужно смотреть на портфель. Во-вторых, ИИ-слой не покупается одной кнопкой — это инженерный проект, который требует времени, команды и интеграции с существующим ландшафтом. В-третьих, ИИ-слой не «завершается» — он живёт и развивается вместе с компанией, обрастает новыми возможностями, обновляет модели, расширяет интеграции.
Зафиксировав целевую архитектуру, мы подходим к следующему вопросу: что именно должна получить компания от такого слоя — на языке бизнес-результата и на языке ИТ-результата. Эту тему мы разворачиваем в следующей главе.
Глава 5
ИИ-слой даёт бизнесу конвейер, а ИТ — управляемость
В предыдущей главе мы зафиксировали целевую архитектуру: единый ИИ-слой между корпоративными системами и бизнес-сценариями. В этой главе мы отвечаем на вопрос «зачем компании в него инвестировать» — но не одной строкой про эффект, а в двух плоскостях, которые в реальности живут параллельно: бизнес и ИТ. Эти эффекты должны быть запланированы одновременно, иначе зрелого ИИ-слоя не получится — получится либо набор разрозненных продуктов без управляемости, либо платформа без пользователей.
5.1. Почему эффекты двусторонние
Когда в крупной компании обсуждают «эффект от внедрения ИИ», бизнес и ИТ говорят про разные вещи. Бизнес говорит про скорость подготовки коммерческих предложений, про снижение времени отклика поддержки, про автоматическую генерацию отчётов, про ускорение работы аналитиков. ИТ говорит про инфраструктурный долг, про политики безопасности, про управление подписками, про эксплуатацию. В большинстве проектов эти два разговора идут параллельно и почти не пересекаются — что порождает типовые перекосы.
Перекос в сторону бизнес-эффектов выглядит так. Компания запускает несколько ярких ИИ-инициатив, каждая показывает измеримый эффект, в отчётах перед правлением — позитивная динамика. Через год обнаруживается: в компании работает 14 различных подписок на ИИ-инструменты, каждый отдел использует свой стек, единого контроля расходов нет, ПД утекают через множество API одновременно, ИБ-блок не может построить целостную картину безопасности. То, что казалось «победой бизнеса», превращается в инфраструктурный долг, который потом приходится разгребать дорого и долго.
Перекос в сторону ИТ-эффектов выглядит иначе. Компания строит образцовую ИИ-платформу — с правильной архитектурой, с governance, с RBAC, с мониторингом, с on-premise. Платформа технически безупречна. Но через год обнаруживается, что на ней работают один-два сценария — потому что бизнес не получил инструмента, который понятно как использовать; владельцы процессов не пришли с идеями; интеграция в реальные процессы не произошла. В отчётах появляется неудобный вопрос «зачем мы потратили N миллионов на инфраструктуру, которой никто не пользуется».
Из обоих типов перекосов следует один и тот же вывод. Эффекты ИИ-слоя нельзя планировать с одной стороны. Стратегия внедрения должна на старте определить, что получает бизнес и что получает ИТ — и движение по этим двум линиям должно идти параллельно. Это и есть, пожалуй, главное практическое следствие из всей теории зрелого ИИ-слоя.

5.2. Что получает бизнес
Когда мы говорим, что бизнес получает «конвейер и управляемость», это не маркетинговая формула — это конкретный набор изменений в том, как работает компания. Ниже — пять характеристик зрелого состояния, каждая из которых видна и измерима.
Предсказуемый конвейер ИИ-инициатив
В незрелом состоянии каждая ИИ-идея превращается в отдельный мини-проект: согласовать с ИТ, найти команду, договориться об инфраструктуре, провести оценку безопасности, договориться об эксплуатации. Этот путь длинный, непредсказуемый по срокам и не имеет понятной точки принятия решения «продолжаем или нет». В результате идеи бизнеса либо тонут, либо ждут полгода до запуска.
В зрелом состоянии у бизнеса есть понятный путь: от идеи до прода за известный срок. Идея проходит стандартизированную последовательность стадий — формулировка, архитектурная оценка, пилот, переход в эксплуатацию, развитие. Каждая стадия имеет понятные сроки, понятный результат и понятную точку принятия решения. Бизнес может на правлении сказать: «У нас 8 идей в работе, 3 на этапе пилота, 2 уже в проде, 3 — на архитектурной оценке. Через два месяца ожидаем перехода в прод ещё двух». Это и называется конвейер.
Тиражируемые сценарии
В незрелом состоянии каждый новый ИИ-сценарий — это новый проект «с нуля»: новые данные, новые доступы, новая команда поддержки, новый цикл ИБ-аудита. Это означает, что стоимость и время запуска N-го сценария примерно равны стоимости и времени запуска первого. При таком положении дел компания достигает потолка в пять-десять сценариев и дальше расти не может — управление сложностью становится непосильным.
В зрелом состоянии новый сценарий собирается из готовых возможностей ИИ-слоя — общая инфраструктура уже работает, каталог данных есть, политики безопасности применены, мониторинг настроен. Запуск нового сценария — это, по сути, описание его специфики на готовом основании. Стоимость и время падают с каждым следующим сценарием, а не остаются постоянными. Компания может позволить себе десятки параллельных сценариев — потому что управление сложностью встроено в инфраструктуру, а не лежит на командах.
Управляемая воронка идей
В незрелом состоянии портфель ИИ-инициатив существует в головах нескольких людей — кого-то из ИТ, кого-то из бизнеса, кого-то из инновационного отдела. Какие идеи в работе, какие отложены, какие забыты — никто не знает целостно. Принять решение «куда инвестировать дополнительные ресурсы» можно только эпизодически, на основании того, что «вспомнили на встрече».
В зрелом состоянии у компании есть единый портфель ИИ-инициатив. Все идеи, поступающие от бизнеса, заводятся в один поток. По каждой видно: автор, владелец, стадия, ожидаемый эффект, статус. На уровне руководства можно увидеть портфельную картину: куда смещается активность, где растёт пайплайн, где есть узкие места. Это превращает работу с ИИ из «чего-нибудь модного» в управляемую инвестиционную деятельность.
Бизнес-метрики на каждый сценарий
В незрелом состоянии измерение эффекта ИИ — это разовое упражнение перед презентацией результатов. Кто-то берёт диктофон, опрашивает пользователей, считает примерные часы, переводит в деньги, готовит слайд. Это работает один раз. На второй год руководство задаёт вопрос «а что с эффектом», и ответ оказывается тем же набором примерных оценок, что и год назад.
В зрелом состоянии каждый сценарий имеет встроенные бизнес-метрики. Time-to-value — за какое время сценарий начал приносить эффект после запуска. Экономия времени или денег — в абсолютных значениях, в сравнении с базой до внедрения. Удовлетворённость пользователей — измеряется регулярно, не разово. Adoption — какой процент целевой аудитории реально использует. Эти метрики собираются автоматически платформой и доступны в любой момент — для отчётности на правлении, для аргументации новых инвестиций, для принятия решения о развитии или остановке сценария.
Понятная процедура запуска
В незрелом состоянии запуск ИИ-инициативы — это вопрос личных связей и инициативности. Кто-то знает, к кому подойти; кто-то умеет добиться внимания ИТ; кто-то готов сам стать драйвером. Это означает, что идеи запускаются не самые лучшие, а самые «продвигаемые». И что десятки потенциально хороших идей просто не доходят до рассмотрения, потому что у их авторов нет ресурсов на «политическое продвижение».
В зрелом состоянии есть единая входная точка для всех ИИ-инициатив. Любой сотрудник компании может зафиксировать идею в общем процессе — и она пройдёт через ту же воронку, что и идея от вице-президента. На каждой стадии понятно, кто принимает решения, по каким критериям, в какие сроки. Это превращает работу с ИИ из «фестиваля энтузиастов» в системную деятельность, которая раскрывает потенциал всей компании, а не только её активной верхушки.
5.3. Что получает ИТ
С точки зрения ИТ-блока зрелый ИИ-слой даёт ровно то, что обычно называют «нормальной корпоративной инфраструктурой» — но применительно к новому классу нагрузки. Никаких революционных терминов: те же принципы единства, контроля, наблюдаемости, что и в других зрелых ИТ-системах. Ниже — пять характеристик.
Единая инфраструктура
В незрелом состоянии «корпоративный ИИ» — это собирательное название для нескольких независимых инструментов, которые компания использует параллельно. Один отдел работает с одним провайдером через прокси. Второй купил готового ассистента. Третий установил коробочный продукт. У каждого свой стек, свой контракт, свой канал поддержки, свои особенности интеграции.
В зрелом состоянии у ИИ есть единая инфраструктура: один контур, один технологический стек, один договор поддержки. Это не означает, что используется только одна модель или один провайдер — это означает, что весь этот зоопарк скрыт за единым интерфейсом для прикладного кода и за единым контуром управления для ИТ. Сменить провайдера, добавить новую модель, изменить политику маршрутизации — это решение, которое принимается в одном месте и применяется ко всем сценариям сразу.
Единый периметр безопасности
В незрелом состоянии безопасность работает «по отделам»: каждый сценарий имеет собственные настройки маскирования, собственную интерпретацию политик, собственный набор интеграций с системами безопасности компании. ИБ-блок не может построить целостную картину — что куда уходит, кто на что имеет доступ, какие риски сейчас активны. И при необходимости что-то изменить нужно обходить десятки команд и просить каждую внести изменения.
В зрелом состоянии все ИИ-запросы проходят через единый периметр безопасности. Маскирование ПД, контроль доступа, аудит, governance — реализованы один раз и применяются автоматически ко всем сценариям. Любое изменение политики (новый класс данных, новый регулятор, новый внутренний регламент) применяется централизованно — и сразу действует во всех сценариях. ИБ-блок видит происходящее как единую картину и может управлять рисками централизованно, а не «бороться с зоопарком».
Единый контроль расходов
В незрелом состоянии расходы на ИИ накапливаются неконтролируемо. Подписки оплачивают разные отделы из разных бюджетов. Расходы на inference у разных провайдеров — разные счета, разные единицы измерения, разные циклы оплаты. Когда финансовый блок задаёт вопрос «сколько мы тратим на ИИ в год», ответ собирается вручную по нескольким источникам и обычно оказывается заниженным.
В зрелом состоянии у компании есть прозрачная финансовая модель ИИ. Все расходы — на подписки, на inference, на инфраструктуру, на эксплуатацию — собираются в одной системе. Видно: сколько стоит каждая модель, каждый сценарий, каждый отдел-пользователь. Можно устанавливать квоты — на уровне пользователя, команды, провайдера. Можно прогнозировать расходы на следующий период. Финансовый контроль ИИ перестаёт быть «постфактумной экспертизой» и становится управляемой статьёй бюджета.
Единый governance
В незрелом состоянии у каждой команды свои подходы к управлению ИИ-системами. Кто-то документирует политики, кто-то нет. Кто-то ведёт логи, кто-то теряет. Кто-то обновляет модели по плану, кто-то — по случаю. Это означает, что качество ИИ-системы зависит от случайных особенностей конкретной команды, и компания не имеет общего стандарта.
В зрелом состоянии есть единая система управления — для прав доступа, для аудита, для жизненного цикла моделей. Кто к чему имеет доступ, кто что менял, когда обновляли модели, какие метрики собираются — всё это в одной системе и доступно для проверки. Это не бюрократия — это базовое требование для крупной компании, без которого нельзя пройти комплаенс-аудит и нельзя обоснованно отвечать регулятору.
Единая команда эксплуатации
В незрелом состоянии эксплуатация ИИ — это «попросить разработчиков». Команда, которая собрала сценарий, продолжает его поддерживать «по совместительству». Когда эта команда переходит к другому проекту, сценарий начинает деградировать — потому что новых людей в курс не вводят, документация устаревает, метрики не отслеживаются.
В зрелом состоянии есть выделенная команда эксплуатации ИИ-слоя. Она отвечает за SLA, за обновления моделей, за разбор инцидентов, за регрессионное тестирование при обновлениях. Прикладные команды разрабатывают сценарии — эксплуатация держит их в продакшене. Это разделение труда позволяет каждой стороне делать своё дело хорошо, а не «и одно, и другое, и третье».
5.4. Почему планировать нужно обе колонки одновременно
Если стратегия концентрируется только на бизнес-колонке — компания получает разрозненные победы, которые через год превращаются в инфраструктурный долг. Если только на ИТ-колонке — получает образцовую платформу без пользователей. Обе ситуации одинаково проигрышные, хотя выглядят по-разному.
Совместное планирование означает, что на каждом этапе работы с ИИ-слоем фиксируются обе группы эффектов. На стадии стратегии: что обещает бизнесу, что обещает ИТ. На стадии архитектуры: какие capabilities закрывают какие группы потребностей. На стадии пилота: какой бизнес-эффект ожидаем, какой инфраструктурный артефакт остаётся после пилота. На стадии эксплуатации: какие KPI бизнеса отслеживаем, какие KPI инфраструктуры. Это не двойной объём работы — это требование зрелости, отличающее системный подход от хаотичного.
Левая колонка эффектов — конвейер бизнес-инициатив — заслуживает отдельного развёртывания. Что именно входит в этот конвейер, как идея бизнеса проходит от формулировки до промышленной эксплуатации, какие стадии в нём есть и за какое время они проходятся. Эту тему мы разворачиваем в следующей главе.
Глава 6
Конвейер ИИ-инициатив
В предыдущей главе мы зафиксировали главное обещание бизнес-колонки эффектов — «предсказуемый конвейер ИИ-инициатив». Это сильное выражение, и его легко превратить в маркетинговый лозунг. В этой главе мы разворачиваем, что именно за ним стоит — какие стадии есть в конвейере, какие сроки реалистичны, что должно быть готово, чтобы конвейер работал, и что меняется в работе компании, когда такой конвейер появляется.
6.1. Зачем нужен конвейер
Когда корпоративная ИИ-инициатива возникает в незрелой среде, её путь от идеи до эксплуатации напоминает прохождение через несколько никем не управляемых очередей. Сначала владелец процесса должен «продать» идею ИТ-команде. Потом ИТ-команда должна найти бюджет и ресурсы. Потом нужно согласовать с ИБ-блоком. Потом получить инфраструктуру. Потом найти, кто будет внедрять. Потом договориться, кто будет поддерживать. На каждой остановке возможна задержка, отказ или возврат на доработку. Сроки непредсказуемы. Точек принятия решений нет — есть точки накопления неопределённости.
Конвейер — это управляемая альтернатива этому хаосу. Не «начнём — посмотрим», а понятная последовательность шагов с известным сроком каждого и понятной точкой принятия решения после каждого. Конвейер не означает, что любая идея обязательно дойдёт до прода — наоборот, он позволяет вовремя останавливать те идеи, которые не имеют экономической перспективы. Но он гарантирует, что движение по этапам происходит управляемо, без зависаний на согласованиях и без сюрпризов «вдруг оказалось, что это технически невозможно».
Принципиально важно, что конвейер не противоречит экспериментальной природе работы с ИИ. Эксперимент происходит внутри стадий — внутри пилота, например. Но между стадиями есть жёсткие точки принятия решения, на которых становится ясно: идём дальше или останавливаемся. Это превращает работу с ИИ из бесконечной серии непредсказуемых проектов в управляемую инвестиционную деятельность.
6.2. Пять стадий конвейера
Конвейер, который, по нашему опыту, работает в крупной компании с готовой ИИ-платформой, состоит из пяти стадий. Каждая имеет понятные входные требования, понятный артефакт на выходе и понятную точку принятия решения о переходе к следующей.
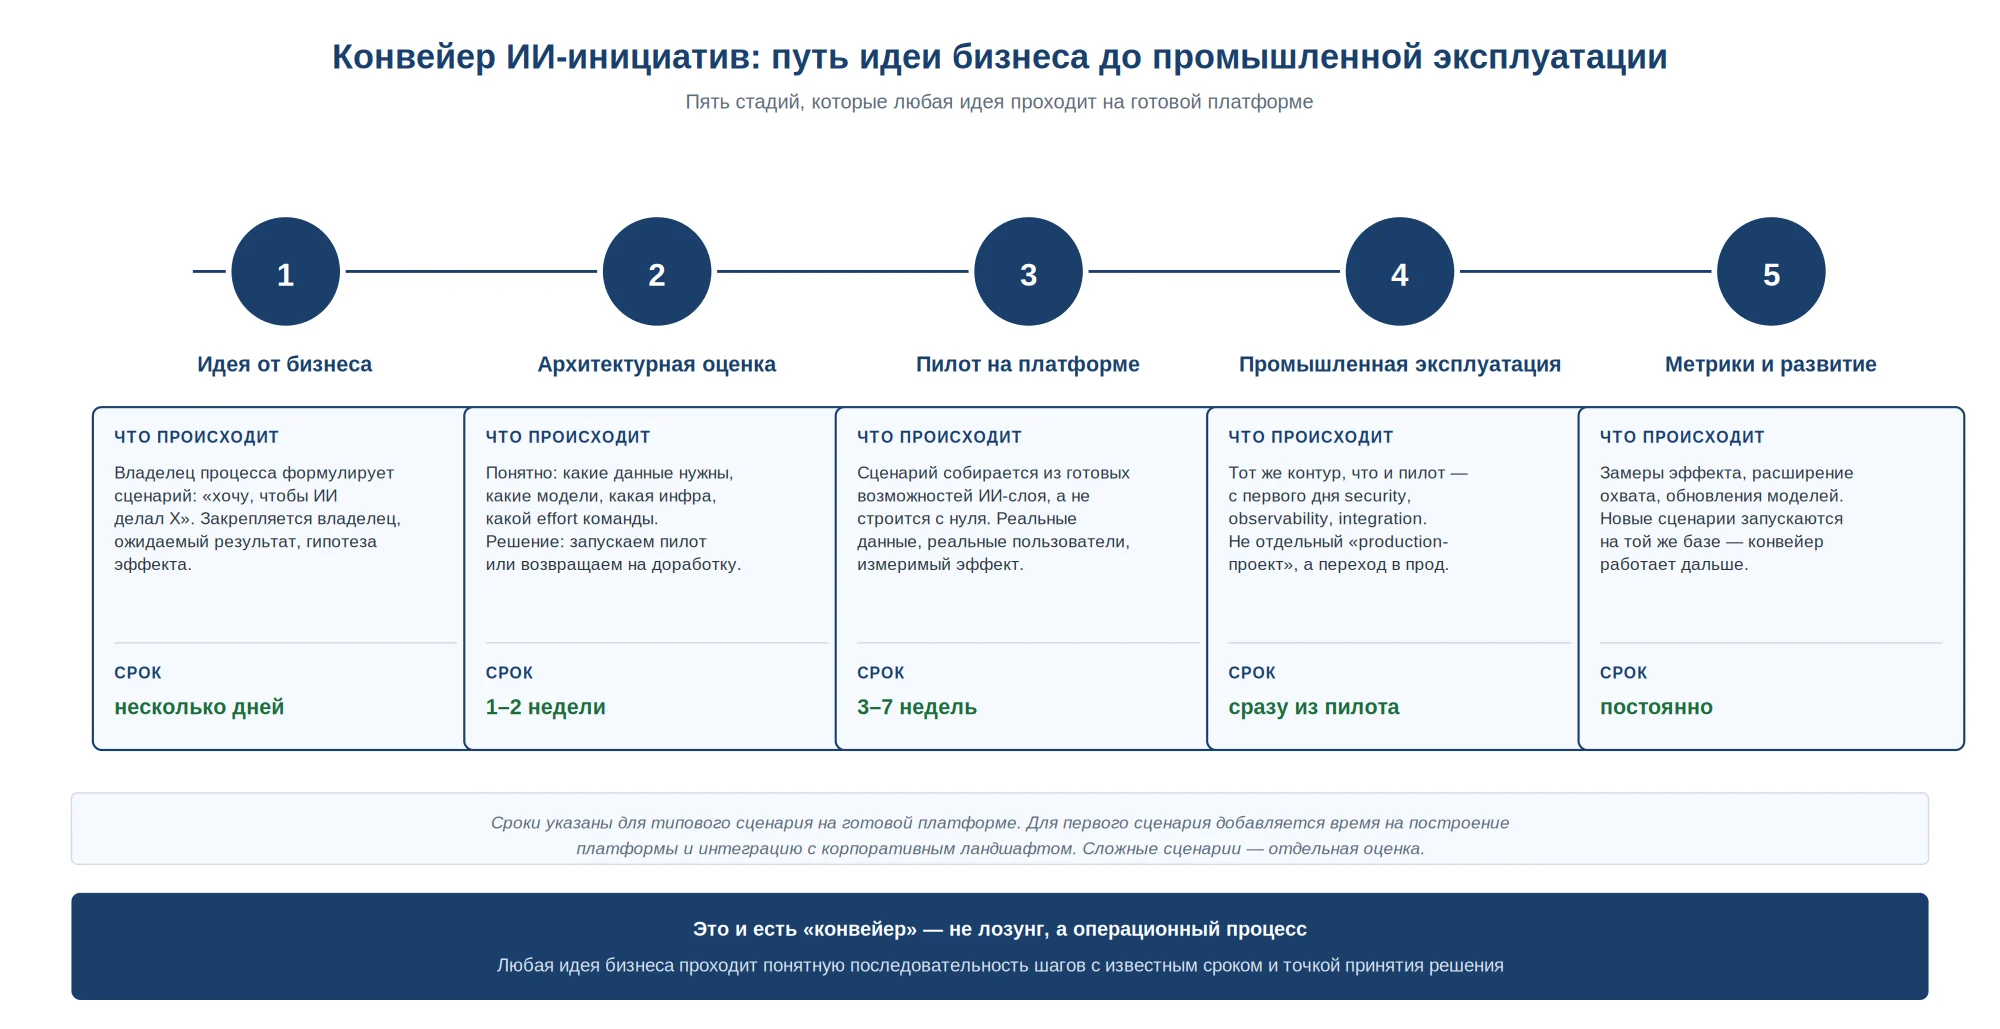
Стадия 1. Идея от бизнеса
Это самая короткая стадия — обычно несколько дней. Её задача — зафиксировать идею в формализованном виде. Не «было бы хорошо ускорить подготовку отчётов», а: какая конкретная задача решается, кто её владелец, какой ожидаемый результат, какая гипотеза эффекта. На этой стадии важно не «продумать всё до конца», а правильно сформулировать — потому что плохо сформулированная идея даст плохую архитектурную оценку на следующей стадии, и весь дальнейший конвейер пойдёт по неверному пути.
Артефакт на выходе — короткое описание сценария: задача, владелец, измеримые цели, граница (что входит в сценарий, что не входит), грубая оценка эффекта. Это документ из 1–2 страниц. Точка принятия решения — простая: «фиксируем идею в бэклоге, переходим к архитектурной оценке» или «возвращаем на доработку, чего-то не хватает». Идеи, которые не проходят эту стадию, не обязательно «плохие» — обычно они недосформулированы, и владельцу нужно вернуться и доработать.
Стадия 2. Архитектурная оценка
Цель этой стадии — понять, что нужно для реализации идеи: какие данные потребуются, какие модели подойдут, какая инфраструктура нужна, какая команда нужна для пилота. Это не «проектирование с точностью до строки кода» — это компетентная оценка обозримых ресурсов. Архитектор смотрит на идею через призму корпоративного ИИ-слоя: какие из готовых capabilities используются, что нужно достроить или интегрировать, какие риски.
Артефакт на выходе — архитектурное заключение: data sources, ожидаемые модели, оценка effort команды, оценка стоимости (включая inference), оценка рисков, рекомендация по сценарию пилота. Точка принятия решения — содержательная: «запускаем пилот», «возвращаем на доработку (нужно изменить scope)», «отказываем (экономика не складывается, либо технических возможностей пока нет)». Эта стадия — единственная защита от пилотов, которые «лучше не запускать», и от инвестиций в архитектурно неудачные идеи.
Стадия 3. Пилот на готовой платформе
Сердце конвейера. Здесь сценарий собирается на готовых возможностях ИИ-слоя — не строится с нуля, не запускается в «песочнице», не делается «для галочки». Пилот работает на реальных данных, с реальными пользователями, с измеримым эффектом. С первого дня — в контуре безопасности, с мониторингом, с интеграциями. Сценарий проектируется так, чтобы из пилота естественно перейти в эксплуатацию, а не «выбросить и переписать».
Для типового сценария на готовой платформе срок пилота — 3–7 недель. Это короче, чем традиционные ИИ-пилоты в незрелой инфраструктуре, по простой причине: значительная часть инфраструктурной работы уже сделана раз и навсегда при построении ИИ-слоя. Не нужно заново настраивать безопасность, не нужно заново интегрироваться с источниками, не нужно с нуля выстраивать мониторинг. Артефакт на выходе — работающий сценарий, отчёт по измеренному эффекту, обоснованное предложение по переводу в эксплуатацию или по остановке. Точка принятия решения: переводим в прод или закрываем.
Стадия 4. Промышленная эксплуатация
В традиционных проектах это отдельный этап с большими доработками — то, что было пилотом, теперь нужно «переписать для продакшена». В зрелом ИИ-слое этого этапа в его обычном понимании нет: пилот изначально работал в production-контуре, и переход в эксплуатацию — это формальное закрепление статуса, передача ответственности команде эксплуатации, расширение охвата на полный круг пользователей. Артефакт на выходе — сценарий в эксплуатации, с зафиксированными SLA, регламентами, метриками.
Это критическое отличие от подхода «сделаем пилот, потом, если получится, перепишем в прод». В нашей логике пилот — это первая итерация production-системы, а не одноразовая демонстрация. Поэтому переход от стадии 3 к стадии 4 не требует значительного времени или ресурсов. Если пилот пришлось сильно переписывать на пути в прод — значит, он был спроектирован неверно. На готовом ИИ-слое этой проблемы не возникает.
Стадия 5. Метрики и развитие
Эта стадия не имеет конца. Сценарий работает, метрики собираются, эффект отслеживается. По мере накопления данных сценарий улучшается: меняются модели, обновляются промпты, расширяется аудитория, добавляются новые случаи использования. Если эффект перестаёт расти или начинает падать — принимается решение о доработке или закрытии. Если эффект растёт — выделяются ресурсы на развитие.
Параллельно с метриками отдельного сценария на этой стадии работает портфельная картина. Видны все сценарии в эксплуатации, их совокупный вклад в результаты компании, тенденции изменений. Эта портфельная картина — то, что превращает работу с ИИ из набора отдельных проектов в управляемую деятельность с осознанным распределением ресурсов.
6.3. Почему это работает только на готовой платформе
Все указанные сроки и плавный переход между стадиями — это характеристики конвейера, который работает на готовом ИИ-слое. Если платформы нет, конвейер выглядит совсем иначе: на стадии 2 архитектор обнаруживает, что нужной инфраструктуры не существует и её придётся строить; стадия 3 затягивается на полгода, потому что параллельно с пилотом строится платформа; переход к стадии 4 требует значительной доработки. В таком режиме говорить о «конвейере» бессмысленно — каждый сценарий идёт по индивидуальному пути.
Это означает важную вещь для стратегии: первый сценарий в компании, у которой нет ИИ-слоя, идёт долго. Срок ощутимо больше типового — потому что параллельно с пилотом строится база. Это не недостаток подхода, это его особенность. Второй сценарий идёт уже по типовым срокам — потому что часть инфраструктуры построена при первом. Третий и далее — по тем же типовым срокам или ещё быстрее. Эффект окупаемости платформы начинается не на первом сценарии, а ближе к пятому-десятому.
Поэтому, когда говорится «3–7 недель пилот» — это правда, но с обязательной оговоркой: при работе на готовой платформе. Без неё все стадии конвейера работают, но сроки растягиваются, и часть инфраструктурных задач приходится решать заново. Эта оговорка должна быть проговорена с заказчиком до того, как он построит ожидание «у вас же написано три-семь недель».
6.4. Что меняется в работе компании
Когда конвейер начинает работать, в компании меняется несколько вещей сразу — и эти изменения часто оказываются важнее, чем эффект от отдельных сценариев.
Появляется единый бэклог ИИ-инициатив. Все идеи — от вице-президента, от руководителя отдела, от рядового сотрудника — попадают в один процесс. Видно: что приходит, что в работе, что завершено, что отклонено и почему. Это превращает портфель ИИ из «того, что в головах нескольких людей» в управляемый ресурс компании.
Появляется ритм прохождения инициатив. Не «когда руки дойдут», а регулярно — например, на еженедельной архитектурной комиссии. Идеи не зависают: каждую неделю кто-то либо переходит на следующую стадию, либо получает обоснованный отказ. Это сильно повышает доверие к процессу со стороны бизнеса — потому что бизнес видит, что его идеи рассматриваются, а не складываются в общую кучу.
Появляется доказательная база эффекта. Через год работы у компании есть несколько десятков сценариев, по каждому из которых известно: когда запустили, какой эффект достигнут, что вложили, как развивается. Это позволяет принимать осмысленные решения о расширении инвестиций в ИИ — не «нам кажется, что эффект есть», а конкретные числа, на которые можно опираться.
Появляется база для масштабирования. Поскольку каждый новый сценарий запускается на готовой инфраструктуре, скорость роста портфеля линейно увеличивается. Если в первый год было 3 сценария, во второй — может быть 10, в третий — 25. Это нелинейный рост, который невозможен в незрелой инфраструктуре, где каждый сценарий требует тех же ресурсов, что и первый.
Из всего сказанного следует вопрос: как понять, на каком уровне зрелости сейчас находится компания и куда конкретно ей нужно расти, чтобы конвейер заработал. Этот вопрос — последний концептуальный элемент нашего подхода — мы разворачиваем в следующей главе.
Глава 7
Метрики зрелости корпоративного ИИ
Зрелый ИИ-слой не возникает одномоментно — компания приходит к нему через последовательность состояний. Карта зрелости в этой главе — практический инструмент самодиагностики: где компания находится сейчас, что именно отличает её состояние от целевого, какие конкретные шаги нужны, чтобы перейти на следующий уровень. Эта карта используется и как опросник для понимания текущей картины, и как ориентир для планирования трансформации.
7.1. Зачем нужна карта зрелости
Без карты зрелости разговор о состоянии корпоративного ИИ ведётся в категориях «хорошо/плохо» или «отстаём/опережаем». Эти оценки неконкретны и обычно ничего не дают для планирования. Если руководитель ИТ-блока говорит «у нас плохо с ИИ» — что именно плохо? Если коммерческий директор говорит «нам нужно догнать рынок» — куда именно догонять? Без структурированной карты эти разговоры ходят по кругу.
Карта зрелости переводит обсуждение в практическую плоскость. По каждой группе метрик понятно: где сейчас, где целевое состояние, какой между ними разрыв. Это позволяет управлять трансформацией как любой другой большой задачей — со строящимся планом, с этапами, с измеримым прогрессом. Без такой карты трансформация ИИ остаётся «общими словами».
Карта не оценочна. Она не говорит, что находиться на уровне «Хаос» плохо. Большинство крупных компаний сейчас именно там — это не свидетельство отставания, это нормальная стартовая точка для отрасли в целом. Карта говорит другое: если компания хочет получать предсказуемые результаты от ИИ, ей нужно последовательно поднимать уровни зрелости. И показывает, какие именно характеристики нужно изменить.
7.2. Четыре группы метрик и три уровня зрелости
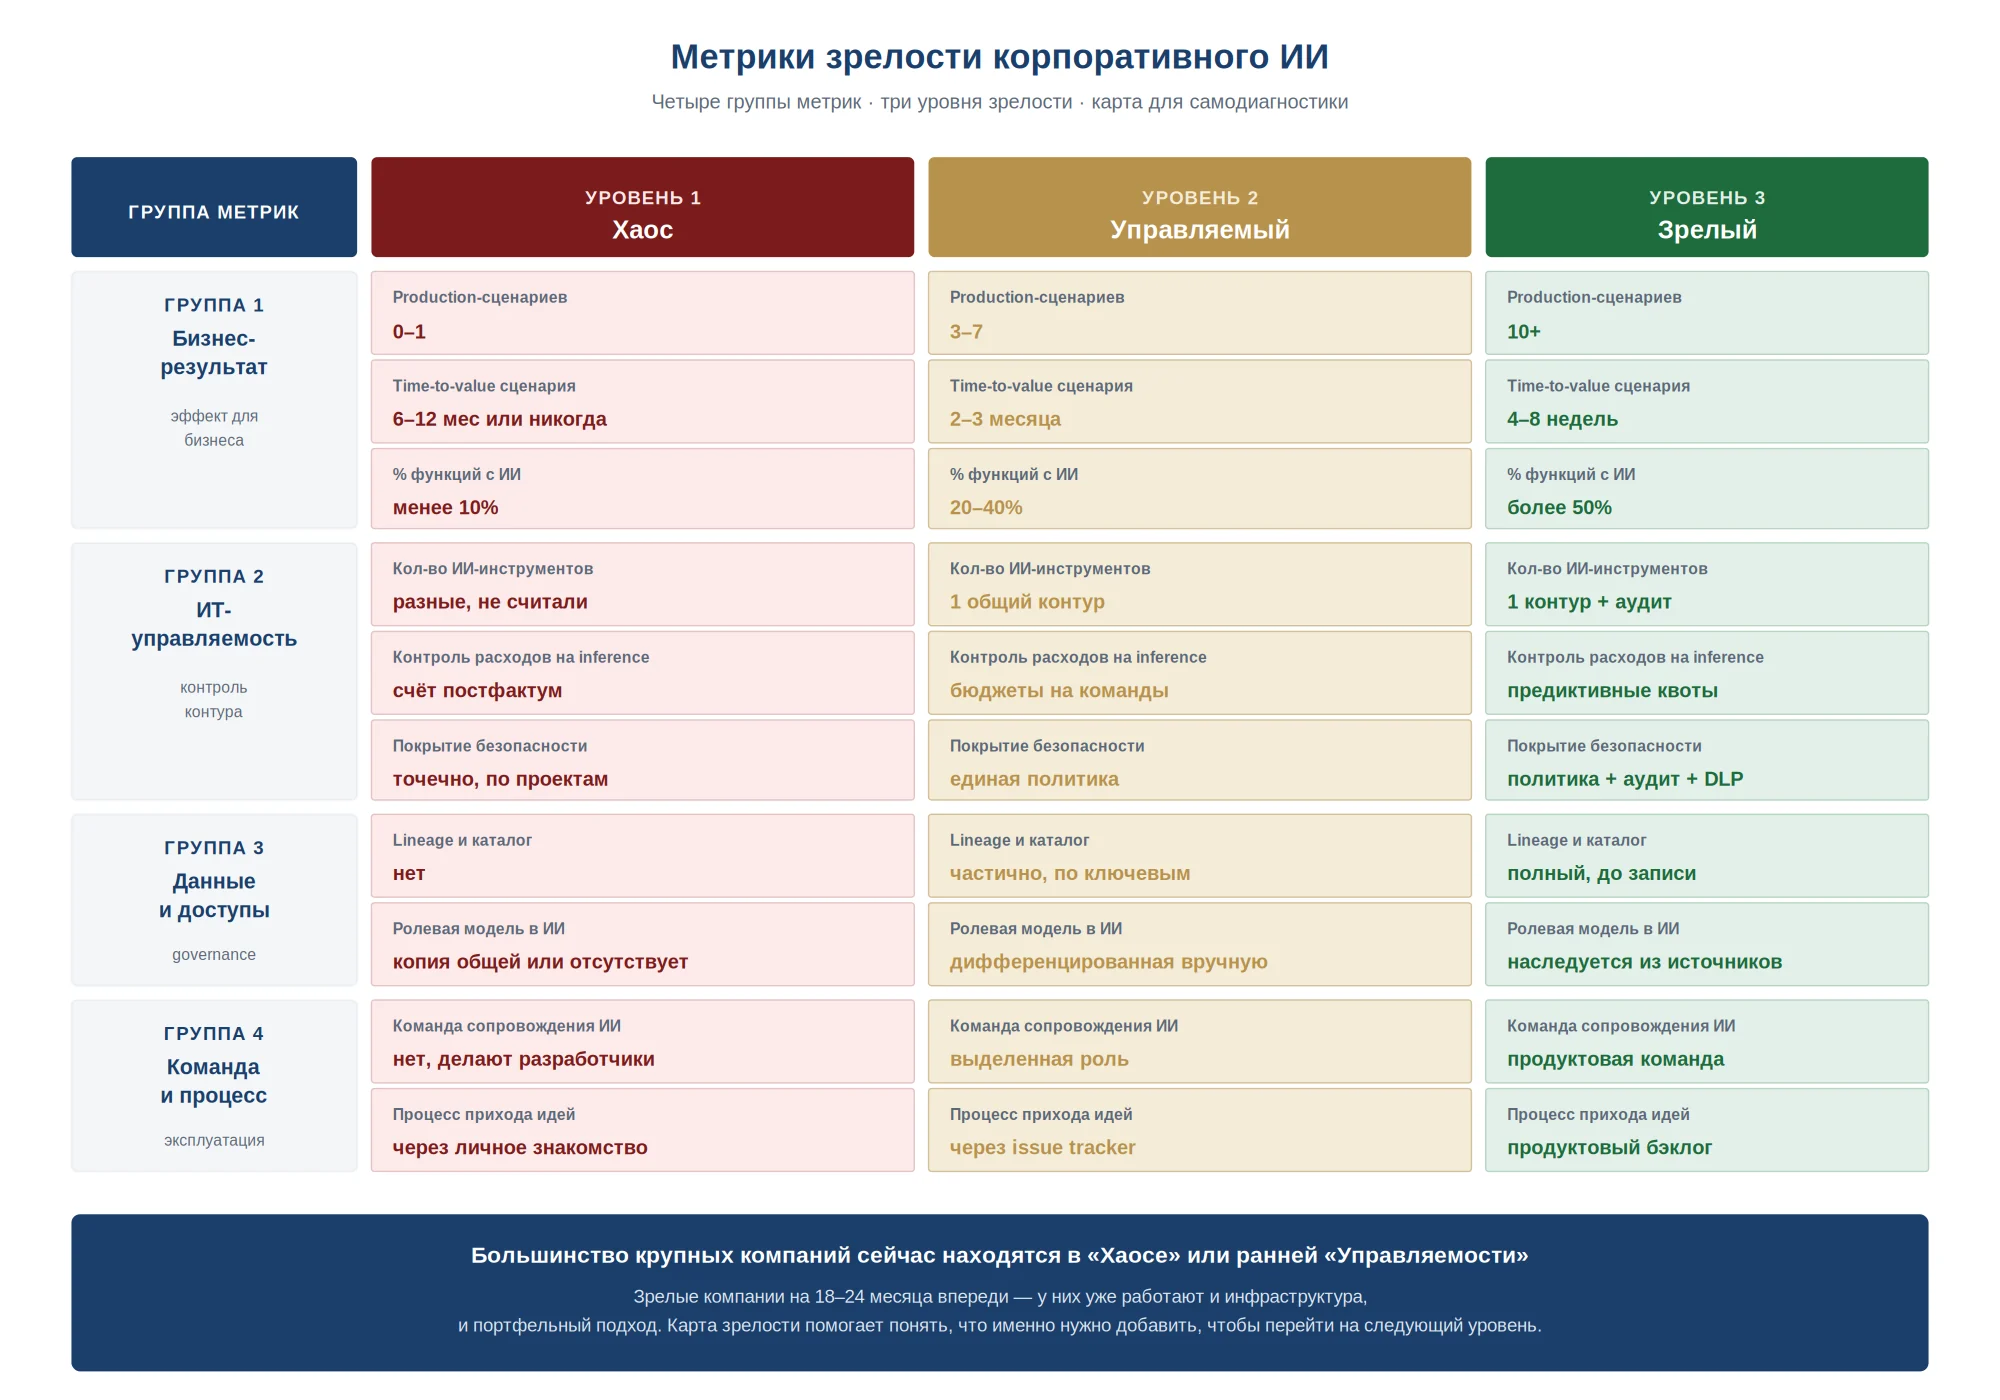
Карта зрелости устроена как матрица. По вертикали — четыре группы метрик, в которых проявляется зрелость ИИ-практики. По горизонтали — три уровня зрелости: Хаос, Управляемый, Зрелый. Внутри матрицы — конкретные характеристики каждой комбинации. Это даёт по каждой ячейке простой и проверяемый ответ «у нас так или не так».
Группы метрик
Бизнес-результат — что компания реально получает от ИИ. Сколько сценариев работает в проде, как быстро запускаются новые, какой процент бизнес-функций реально использует ИИ. Это самая «видимая» группа — её показывают на правлении, по ней судят о практическом эффекте.
ИТ-управляемость — как устроен контроль над ИИ-инфраструктурой. Сколько контуров, кто их видит, как считаются расходы, как покрыта безопасность. Эта группа — внутренняя для ИТ-блока, но она определяет устойчивость всей конструкции и её способность к масштабированию.
Данные и доступы — как устроена работа с данными в ИИ. Есть ли каталог, есть ли lineage, как наследуется ролевая модель. Эта группа отделяет компании, которые научились управлять данными как корпоративным активом, от компаний, у которых данные живут «в системах сами по себе».
Команда и процесс — как устроена операционная составляющая. Кто отвечает за поддержку ИИ-сервисов, по какому процессу приходят идеи, как принимаются решения о развитии. Эта группа определяет, превращается ли работа с ИИ из «увлечения отдельных энтузиастов» в системную деятельность.
Уровни зрелости
Хаос — состояние, когда работа с ИИ происходит, но не управляется. Есть отдельные пилоты, отдельные подписки, отдельные команды. Никто целиком не видит картину. Решения принимаются ситуативно. Это нормальное стартовое состояние для большинства крупных компаний сейчас — не повод для самокритики, а отправная точка для движения.
Управляемый — состояние, когда базовая инфраструктура построена, политики формализованы, процессы зафиксированы. Видна общая картина. Появилась дисциплина управления. Эффект от ИИ становится регулярным, а не разовым. Это переходный уровень — обычно компания находится здесь 1–2 года, по мере того как достраивает недостающие элементы.
Зрелый — состояние, когда ИИ-слой работает как полноценная корпоративная инфраструктура. Конвейер запускает новые сценарии в типовые сроки. Портфель управляется как любая другая инвестиционная деятельность. Эффект ИИ встроен в операционную модель компании. Это целевое состояние, к которому идёт движение.
7.3. Полная карта зрелости
Ниже — полная матрица: четыре группы метрик, по каждой — конкретные показатели в каждом из трёх уровней. Это рабочий инструмент: его можно распечатать, пройти по строкам и отметить, в каком уровне находится компания по каждой строке.
7.4. Как использовать карту
Карта используется в трёх режимах — каждый из них даёт компании конкретное практическое знание.
Самодиагностика
В формате внутренней работы — ИТ-блок, бизнес-владельцы и ИБ-блок проходят по каждой строке и фиксируют текущее состояние. Это даёт срез: где компания сильна, где слаба, где есть несоответствие представлений (бизнес считает, что всё хорошо, а ИТ показывает, что инфраструктура отстаёт). Такая работа полезна тем, что вынуждает разные блоки компании говорить про ИИ на одном языке и приходить к общему пониманию.
Обычно по итогам самодиагностики выясняется, что компания неоднородна: по одним группам она уже в «Управляемом» уровне, по другим — ещё в «Хаосе». Это нормально. Карта позволяет точно показать, где именно нужны действия, и не распылять ресурсы на области, которые и так уже работают.
Планирование трансформации
После того как зафиксировано текущее состояние, карта используется для планирования. По каждой строке, где компания хочет подняться на следующий уровень, определяются конкретные действия. Например: чтобы перейти от «расходы постфактум» к «бюджеты на команды» — нужно настроить квоты в AI Gateway, привязать их к корпоративным центрам затрат, провести обучение финансового блока. Это не один большой проект «трансформация ИИ» — это набор адресных шагов, каждый из которых сам по себе обозрим.
Обычно компании рекомендуется не пытаться сразу перейти от «Хаоса» к «Зрелому» по всем строкам — это даёт слишком большой объём изменений одновременно. Реалистичный план — выбрать несколько ключевых строк, по которым отставание создаёт наибольшие риски (как правило, это безопасность и контроль расходов), и сначала поднять их. Остальные подтянутся по мере того, как будет строиться общая инфраструктура.
Отслеживание прогресса
В режиме регулярной работы карта применяется как трекер. Например, раз в квартал команда трансформации проходит по строкам и отмечает изменения. Это даёт визуально понятную картину прогресса для руководства: «полгода назад мы были тут, сейчас здесь, целимся в следующий уровень за столько-то». Без такого регулярного замера трансформация ИИ перестаёт быть управляемой деятельностью и превращается в «общие усилия неизвестно куда».
7.5. Где обычно находятся крупные компании сейчас
По нашему опыту работы с крупными российскими компаниями, типичная картина такая. По бизнес-результату — преимущественно «Хаос» и «Управляемый»: несколько пилотов, иногда один-два работающих сценария, бизнес-метрики измеряются ситуативно. По ИТ-управляемости — чаще всего «Хаос»: единого контура нет, расходы видны постфактум, безопасность точечная. По данным и доступам — «Хаос» преобладает: каталога нет, ролевая модель не унифицирована. По команде и процессу — между «Хаосом» и «Управляемым»: иногда есть выделенный человек, иногда нет, формальный процесс прихода идей встречается редко.
Это означает, что большинство крупных компаний сейчас одинаково находятся в начале пути. Это не плохо — это объективная ситуация рынка. Те, кто на 18–24 месяца впереди — это компании, целенаправленно строящие ИИ-слой как инфраструктурный приоритет, с выделенной командой и продуктовым подходом. Разрыв между «лидерами» и «средним рынком» сейчас в основном вопрос управленческой воли, а не доступности технологий — технологии для построения зрелого ИИ-слоя доступны всем.
Зафиксировав целевую архитектуру (глава 4), двусторонние эффекты (глава 5), операционный конвейер (глава 6) и карту зрелости (глава 7), мы переходим к практической реализации. В следующей главе мы описываем нашу платформу — корпоративную ИИ-инфраструктуру, которая реализует всё, о чём шла речь выше.
Глава 8
Реализация: корпоративная ИИ-платформа
В предыдущих главах мы договорились о подходе: ИИ-слой как инженерная инфраструктура, чек-лист из вопросов внедрения, целевая архитектура, эффекты для бизнеса и ИТ, конвейер инициатив и метрики зрелости. Здесь заканчивается методика и начинается часть II — рассказ о том, как этот подход реализуем мы. Эта глава отвечает на закономерный вопрос — как именно подход воплощён в продукте. Мы описываем корпоративную ИИ-платформу «Камерата»: как она устроена, какие сценарии покрывает и какой технический контур обеспечивает. Принципы первой части применимы и с другими инструментами; коммерческие условия мы раскрываем отдельно.
8.1. От принципов к инструменту
На протяжении первой части мы сознательно не называли конкретных продуктов. Это было принципиально: сначала нужно договориться о том, что мы считаем правильным устройством корпоративного ИИ, и только потом показывать инструмент, который этому устройству соответствует. Если перевернуть этот порядок — начать с продукта, а подход подгонять под него, — получится ровно та ситуация, которую мы критиковали во второй главе: красивая витрина без инженерной основы.
Целевая архитектура из главы 4 предъявляет к платформе жёсткие требования. Это должен быть не отдельный ассистент и не набор слабо связанных сервисов, а единый слой между корпоративными системами и бизнес-сценариями, который реализует все шесть возможностей ИИ-слоя, держит безопасность сквозным контуром и одинаково хорошо работает на трёх типах задач. Платформа, которую мы описываем ниже, спроектирована именно под эти требования — поэтому глава 8 читается как прямое продолжение главы 4. Это не нейтральный обзор рынка, а наша реализация — и мы проверяем её теми же требованиями, что сформулировали в части I.
Мы разбираем платформу в три захода: сначала её архитектура — четыре слоя, повторяющие логику целевой модели; затем три типа сценариев, которые на ней запускаются; и наконец технический контур — безопасность, стек и развёртывание, то есть всё, что превращает архитектурную схему в эксплуатируемую систему.
8.2. Архитектура платформы
Платформа устроена как четыре горизонтальных слоя. Снизу — корпоративные системы компании, сверху — прикладные сценарии для бизнеса, между ними — платформенные сервисы и сквозной контур безопасности. Эта структура не случайна: она зеркально повторяет целевую архитектуру из главы 4, где ИИ-слой располагается между источниками данных и бизнес-задачами. Схема ниже показывает все четыре слоя и ключевые характеристики платформы.
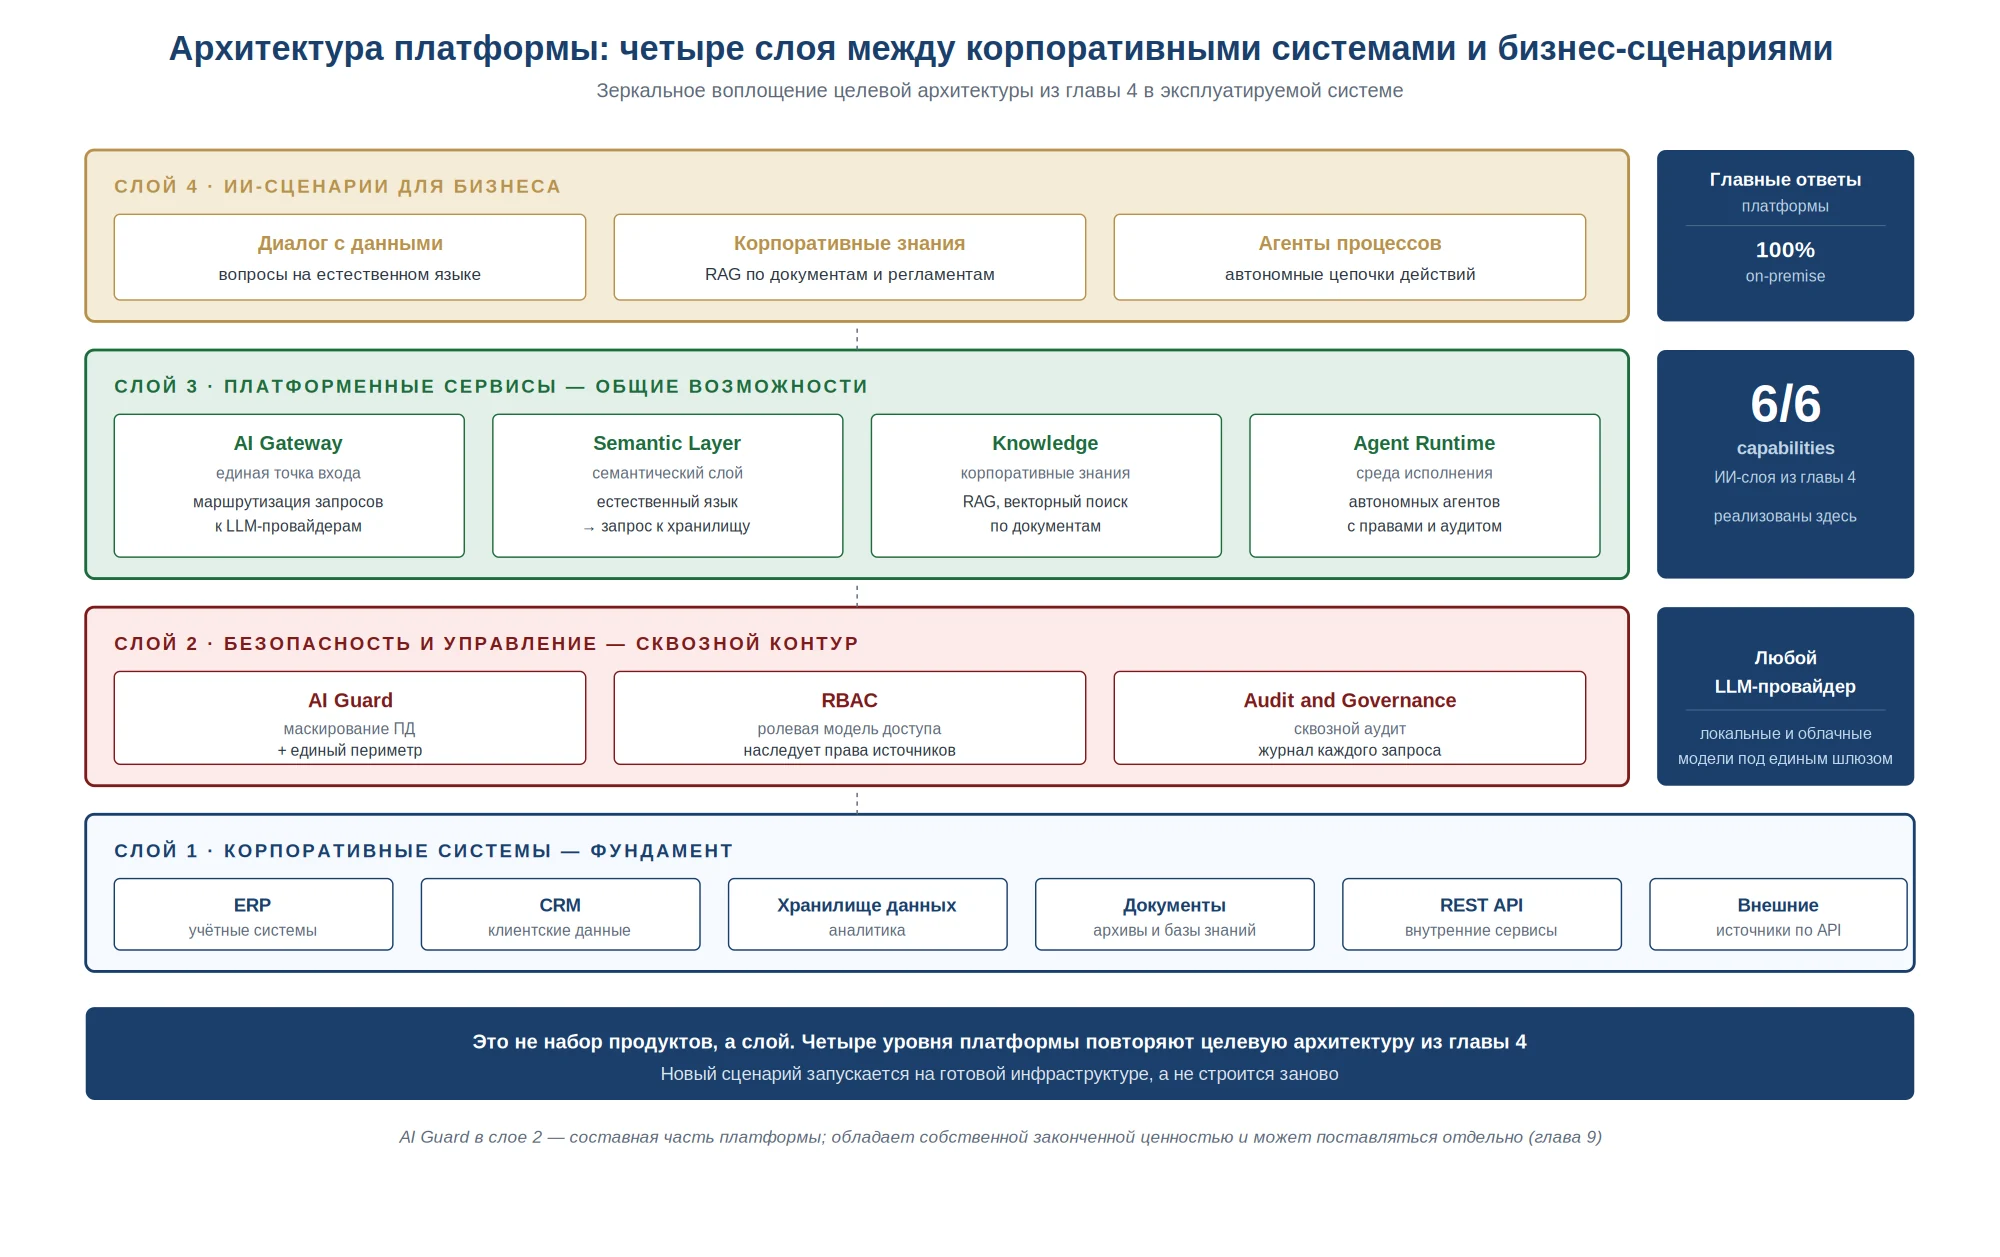
Корпоративные системы — фундамент
Нижний слой — это существующий ИТ-ландшафт компании: ERP, CRM, корпоративное хранилище данных, документные архивы, внутренние API. Платформа не заменяет эти системы и не требует их переписывать. Она подключается к ним как потребитель данных и, при необходимости, как исполнитель действий. Это принципиально: мы не строим параллельную реальность, а надстраиваемся над тем, что у компании уже есть и во что уже вложены деньги.
Безопасность и управление — сквозной слой
Над источниками располагается слой безопасности и управления: маскирование персональных данных (AI Guard), ролевая модель доступа (RBAC), аудит и governance. Мы поместили его именно здесь — ниже платформенных сервисов и сценариев — сознательно. Безопасность в корпоративном ИИ не может быть «фильтром на выходе»; она должна работать до того, как данные попадут в модель, и контролировать каждый запрос на всём пути. Любое обращение к данным проходит через этот слой: права пользователя проверяются, персональные данные маскируются, факт запроса журналируется.
AI Guard здесь показан как составная часть платформы — один из барьеров общего контура безопасности. При этом он обладает собственной законченной функциональностью и может поставляться отдельно, как самостоятельный продукт; этот сценарий мы рассматриваем в отдельной главе. В рамках платформы важно одно: маскирование персональных данных встроено в контур по умолчанию, а не докупается потом.
Платформенные сервисы — общие возможности
Третий слой — это набор базовых возможностей, на которых работает любой сценарий: AI Gateway (единая точка входа и маршрутизация запросов к моделям), Semantic Layer (семантический слой над данными, превращающий вопрос на естественном языке в корректный запрос к источникам), Knowledge (поиск и работа с корпоративными знаниями по технологии RAG) и Agent Runtime (среда исполнения автономных агентов). Именно этот слой реализует те шесть возможностей ИИ-слоя, которые мы перечислили в главе 4 — отсюда пометка «6 из 6» на схеме.
Ключевая идея слоя — переиспользование. Когда в компании появляется новый сценарий, он не строится с нуля: он опирается на уже существующие AI Gateway, семантический слой, базу знаний и среду агентов. Это прямое продолжение тезиса главы 4 о том, что ИИ-слой окупается не на первом сценарии, а на десятом.
ИИ-сценарии для бизнеса — верхний слой
Самый верхний слой — то, что видит конечный пользователь: прикладные сценарии, сгруппированные в три типа (диалог с данными, корпоративные знания, агенты процессов). Этот слой мы подробно разбираем в следующем разделе. Здесь достаточно зафиксировать: сценарии — это «витрина» платформы, но работают они не сами по себе, а на трёх нижних слоях. Богатство верхнего слоя прямо зависит от зрелости того, что под ним.
Справа на схеме вынесены три характеристики, которые отвечают на главные вопросы разных ролей. «100% on-premise» — данные не покидают периметр компании, ключевой аргумент для ИТ и ИБ. «6 из 6» — платформа реализует все возможности ИИ-слоя из главы 4, а не их часть. «Любой LLM-провайдер» — платформа не привязана к одной модели: модели внутри вашего периметра и облачные подключаются под единым шлюзом и маршрутизируются под конкретную задачу через AI Gateway.
8.3. Один контур — три типа ИИ-сценариев
Платформа покрывает не один класс задач, а три. Это важно: за «корпоративным ИИ» часто скрывается либо только чат-ассистент по документам, либо только аналитика по данным. Зрелый ИИ-слой должен уметь и то, и другое, и третье — на общей инфраструктуре. Схема ниже показывает три типа сценариев и то общее, что объединяет их в единый контур.
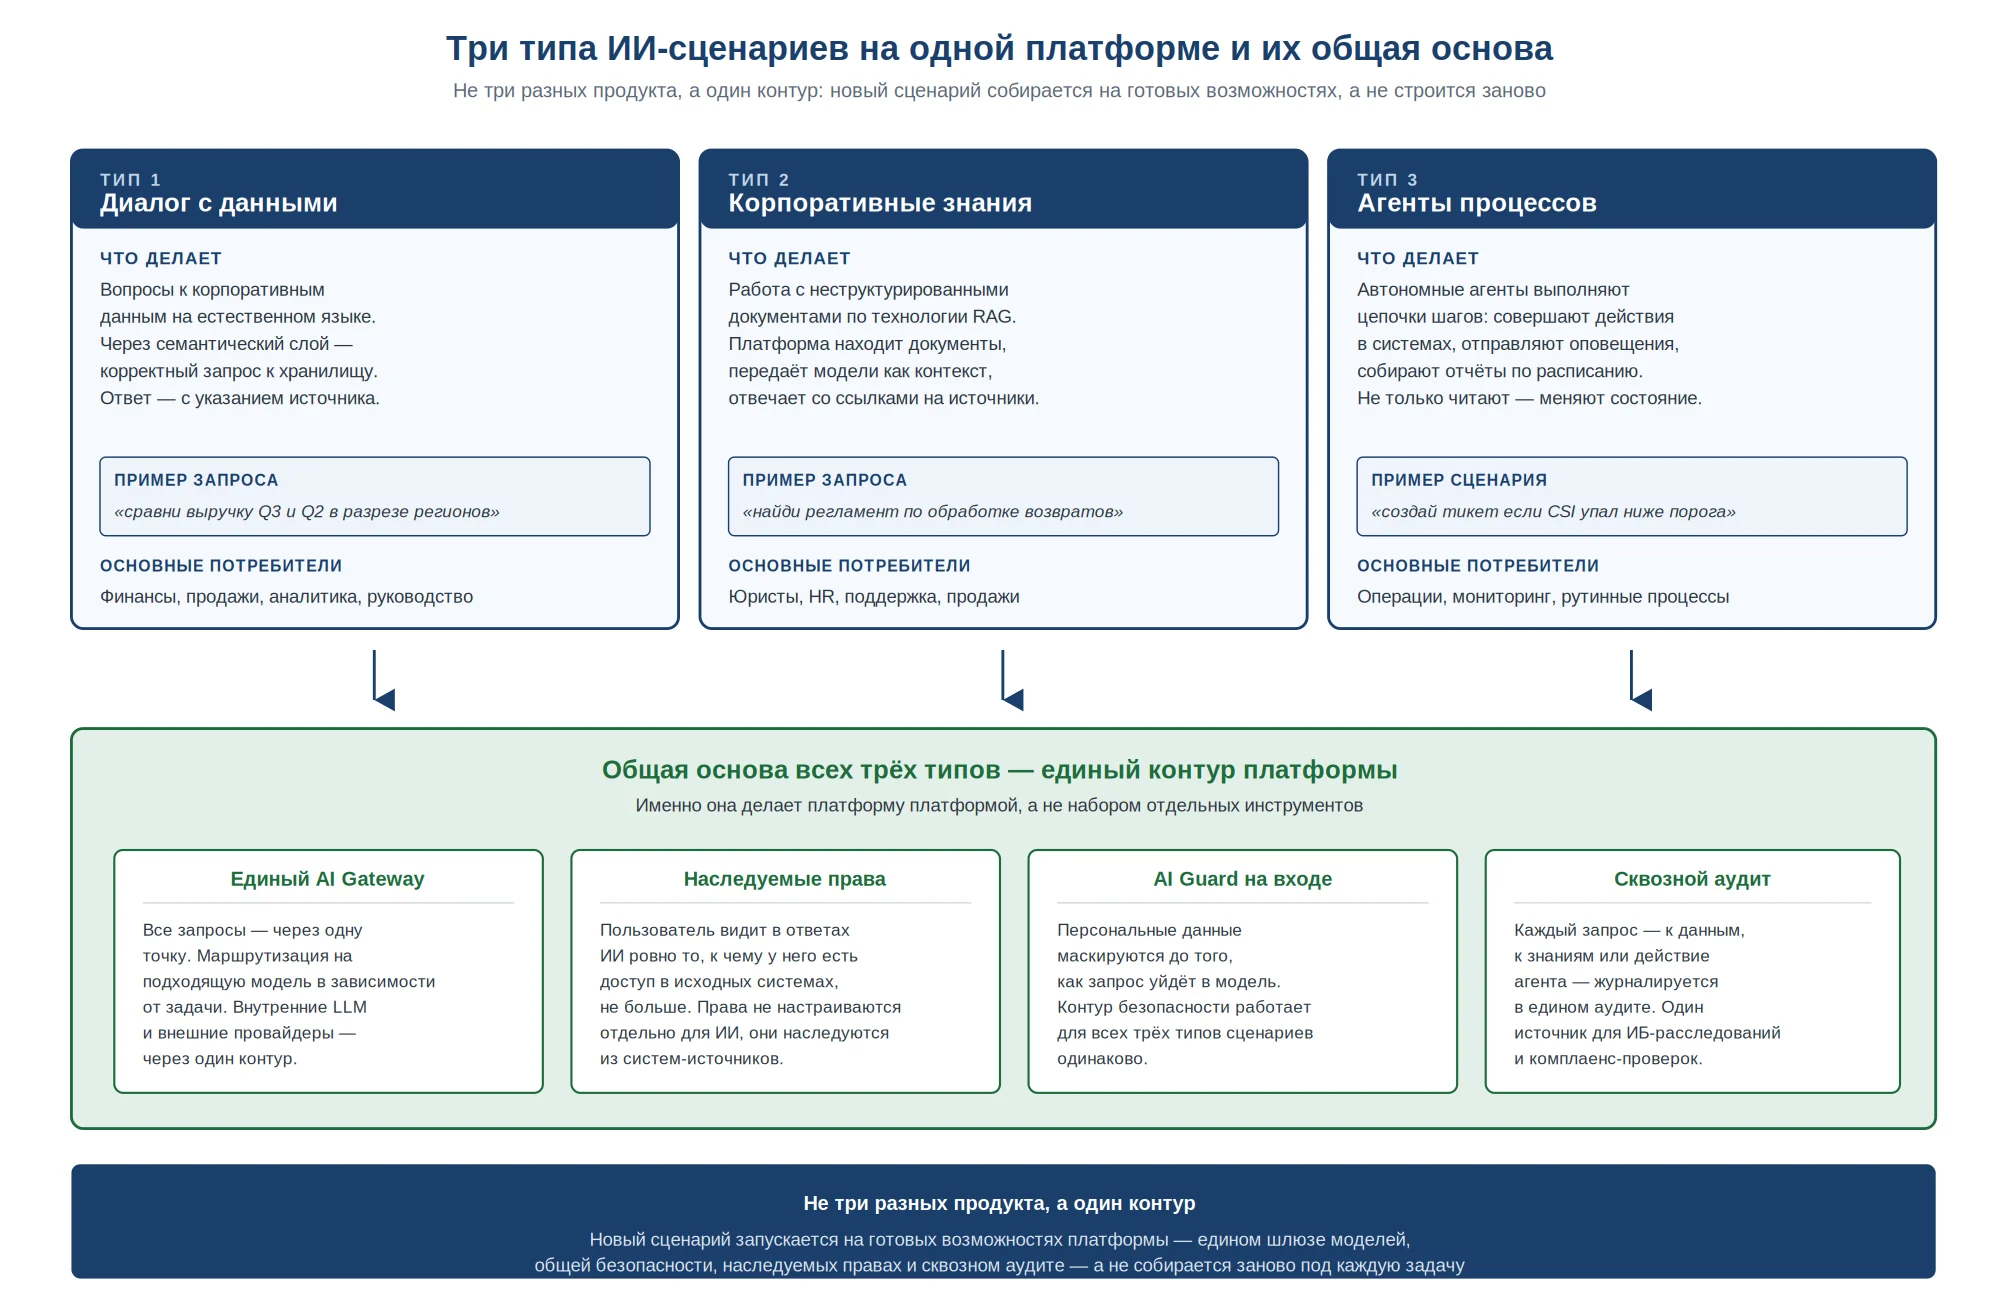
Диалог с данными
Первый тип — вопросы к корпоративным данным на естественном языке. Пользователь формулирует вопрос по-русски — «сравни выручку третьего и второго кварталов в разрезе регионов» или «кто из менеджеров закрыл больше сделок». Платформа через семантический слой превращает вопрос в корректный запрос к хранилищу, выполняет его и возвращает ответ — с обязательным указанием источника, на основе которого он получен. Цитирование источника здесь не украшение, а требование доверия: руководитель должен видеть, откуда взялась цифра. Главные потребители этого сценария — финансы, продажи, аналитика и руководство.
Корпоративные знания
Второй тип — работа с неструктурированными корпоративными знаниями: документами, регламентами, перепиской, базой обращений. Здесь работает технология RAG: платформа находит в корпоративном архиве релевантные документы, передаёт их модели как контекст и формирует ответ, опираясь именно на эти источники, а не на «общие знания» модели. Это закрывает типовую боль крупной компании, где найти нужный регламент или вспомнить, что обсуждалось на встрече с клиентом, занимает часы. Ответ сопровождается ссылками на конкретные документы и пункты. Основные потребители — юристы, HR, поддержка и продажи.
Агенты процессов
Третий тип — автономные агенты, выполняющие цепочки шагов: не просто отвечают на вопрос, а совершают действия в системах, отправляют оповещения, собирают отчёты по расписанию. Например, агент может создать тикет в Jira, если индекс удовлетворённости упал ниже порога, или ежедневно собирать управленческий отчёт с текстовым нарративом. Это наиболее «активный» тип сценария: агент не только читает данные, но и меняет состояние систем — поэтому он особенно сильно зависит от слоёв безопасности и прав доступа. Основные потребители — операционные подразделения, мониторинг и команды, перегруженные рутиной.
Здесь стоит сделать честную оговорку. Три типа сценариев — это не три одинаково зрелых направления, а единая инфраструктура, на которой каждый из них реализуется. Диалог с данными и работа со знаниями опираются на одни и те же платформенные сервисы; агенты процессов используют их как строительные блоки. Ценность платформы не в том, что «всё уже готово на каждом сценарии», а в том, что любой из трёх типов запускается на общей основе, а не строится с нуля.
Что общего у всех трёх
Объединяет три типа сценариев именно то, что делает платформу платформой, а не набором инструментов. Все они проходят через единый AI Gateway, который маршрутизирует запрос на подходящую модель. У всех права доступа наследуются из систем-источников — пользователь видит в ответах ИИ ровно то, к чему у него есть доступ в исходных системах, не больше. У всех персональные данные маскируются до того, как запрос уйдёт в модель. И каждый запрос — к данным, к знаниям или действие агента — журналируется в едином аудите.
8.4. Технический контур: безопасность, стек, развёртывание
Архитектура и сценарии отвечают на вопрос «что платформа делает». Технический контур отвечает на вопрос «как это безопасно эксплуатировать в крупной компании» — и именно этот раздел чаще всего читают ИТ и ИБ. Мы разбиваем его на три блока: безопасность, технологический стек и то, что получает каждая роль. Схема ниже сводит их вместе.
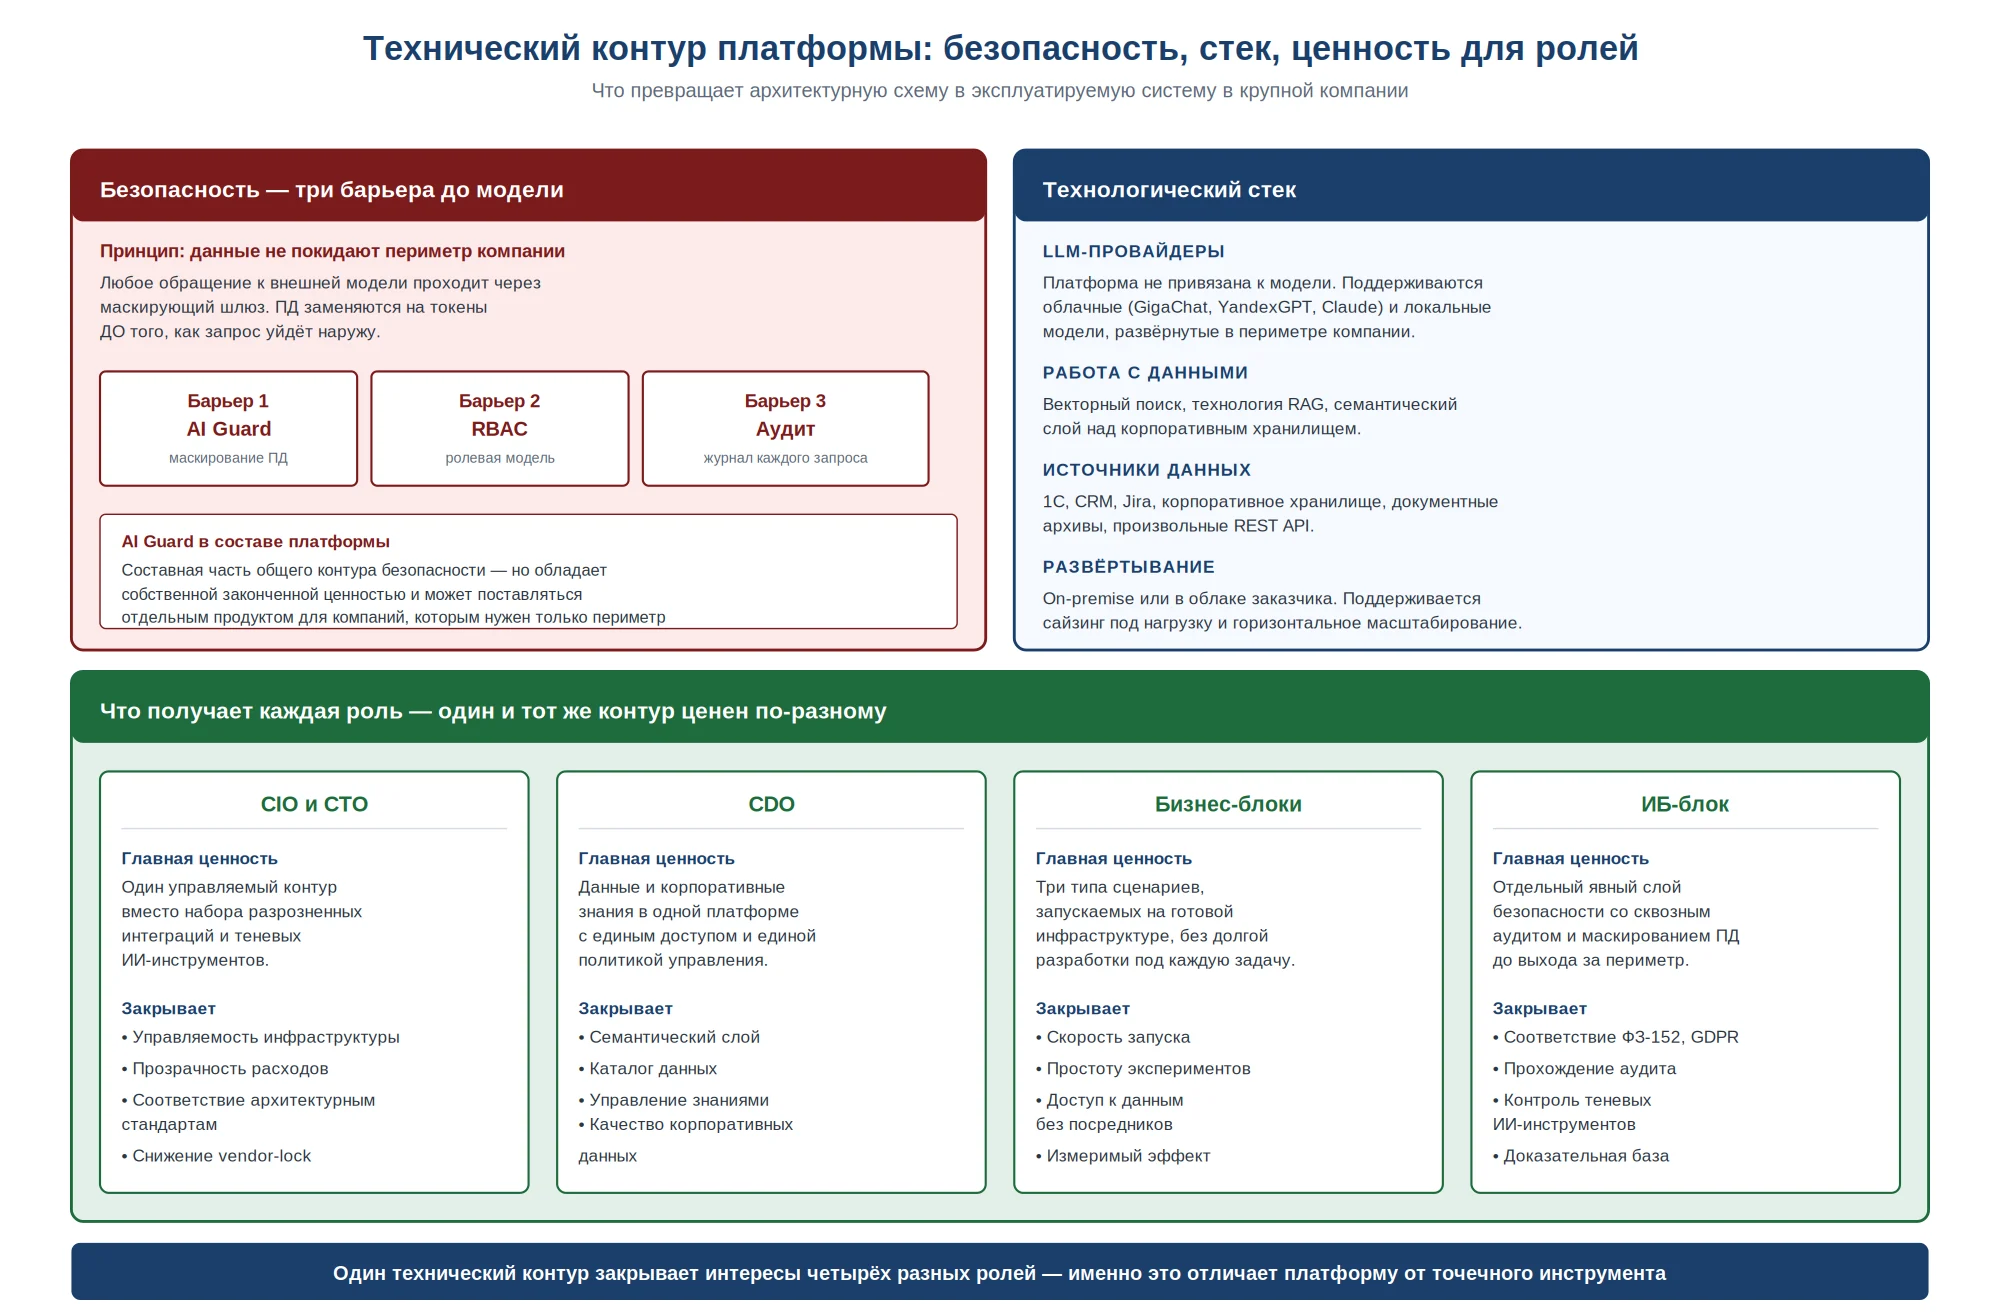
Безопасность
Основной принцип — данные не покидают периметр компании. Любое обращение к внешней модели проходит через маскирующий шлюз, который маскирует персональные данные — заменяет их на токены — до того, как запрос уйдёт наружу. Между пользователем и моделью стоят три барьера: AI Guard маскирует персональные данные, ролевая модель (RBAC) ограничивает доступ — права наследуются из систем-источников, а не настраиваются отдельно, — и аудит фиксирует каждый запрос и ответ. AI Guard, как уже отмечено, является составной частью платформы, но при этом обладает собственной законченной ценностью и может поставляться отдельным продуктом.
Технологический стек
Платформа не привязана к конкретной модели. Поддерживаются любые LLM — облачные и локальные модели, развёрнутые в периметре компании, под единым шлюзом. Работа с данными строится на векторном поиске, технологии RAG и семантическом слое над корпоративным хранилищем. В качестве источников подключаются 1С, CRM, системы вроде Jira, корпоративное хранилище, документные архивы и произвольные REST API. Развёртывание возможно как полностью on-premise, так и в облаке заказчика; платформа поддерживает сайзинг под прогнозируемую нагрузку и горизонтальное масштабирование по мере роста числа сценариев.
Что получает каждая роль
Один и тот же технический контур по-разному ценен для разных ролей, и это сознательное свойство платформы. CIO и CTO получают один управляемый контур вместо набора разрозненных интеграций и теневых ИИ-инструментов. CDO — данные и корпоративные знания в одной платформе с единым доступом. Бизнес — три типа сценариев, запускаемых на готовой инфраструктуре, без долгой разработки под каждую задачу. ИБ — отдельный, явный слой безопасности со сквозным аудитом и маскированием персональных данных до выхода за периметр. Именно это совмещение интересов разных ролей в одном решении и отличает платформу от точечного инструмента.
8.5. Почему это и есть реализация целевой архитектуры
Если сопоставить эту главу с главой 4, видно, что платформа — не «ещё один продукт на рынке», а прямое инженерное воплощение принципов, которые мы защищали на протяжении всего документа. Четыре слоя платформы повторяют целевую архитектуру: корпоративные системы как фундамент, сквозная безопасность, общие платформенные сервисы и прикладные сценарии сверху. Шесть возможностей ИИ-слоя из главы 4 реализованы в слое платформенных сервисов. Тезис главы 4 о переиспользовании — «окупается не на первом сценарии, а на десятом» — превращается здесь в конкретный механизм: новый сценарий собирается на готовых шлюзе, семантическом слое, знаниях и среде агентов.
Точно так же замыкаются и другие главы. Чек-лист вопросов внедрения из главы 3 получает ответы: данные — через семантический слой и подключение источников, безопасность — через сквозной контур и маскирование, контур и стоимость — через on-premise-развёртывание и маршрутизацию моделей, эксплуатация — через аудит и наблюдаемость. Двойной эффект для бизнеса и ИТ из главы 5 обеспечивается тем, что один контур одновременно даёт бизнесу конвейер сценариев, а ИТ — управляемость. Конвейер инициатив из главы 6 работает именно потому, что под ним есть готовая платформа, а не пустое место.
Поэтому документ устроен так, как устроен. Сначала — диагноз и принципы, в самом конце — инструмент. Платформа здесь не точка назначения, а доказательство того, что подход, описанный в предыдущих главах, реализуем не на словах, а в эксплуатируемой системе. Шлюз безопасности, формат внешней инженерной команды и программа обучения — три остальные практики — описаны в следующих главах. Коммерческие условия, дорожная карта внедрения и кейсы — следующий уровень разговора, который мы ведём уже на встрече.
Глава 9
AI Guard — единый периметр безопасности корпоративного ИИ
Глава 8 описала корпоративную ИИ-платформу как воплощение целевой архитектуры. AI Guard был упомянут в составе её безопасностного слоя — как один из трёх барьеров защиты данных. В этой главе мы раскрываем «Камерата AI Guard» как самостоятельный продукт, который может поставляться отдельно — для компаний, которым нужен только защищённый периметр работы с ИИ, без необходимости внедрять полную платформу. Глава содержит развёрнутое архитектурное описание решения, его технические характеристики, режимы эксплуатации и принципы интеграции в существующий ландшафт.
9.1. От компонента платформы — к самостоятельному продукту
AI Guard изначально создавался как один из ключевых модулей корпоративной ИИ-платформы. В архитектуре платформы это слой между внутренними сервисами и внешними LLM, который обеспечивает соответствие требованиям ИБ-блока. Однако в ходе работы с заказчиками стало понятно, что эта компонента имеет самостоятельную ценность вне платформы. Компания, у которой уже есть свой ИИ-стек, свои ассистенты, свои интеграции с LLM-провайдерами, часто сталкивается с единственной проблемой: как сделать всё это безопасным для корпоративных данных и одобренным ИБ-блоком. Развёртывать ради этого полную платформу избыточно — нужна только защита периметра.
Поэтому AI Guard доступен в двух режимах поставки. Первый — как составная часть корпоративной ИИ-платформы: интегрирован в общую архитектуру, использует общий каталог пользователей, общий аудит, общую инфраструктуру. Второй — как самостоятельный лицензируемый продукт, который встраивается в любой существующий ИИ-стек без переделок и обеспечивает безопасный периметр для работы с языковыми моделями. В обоих режимах функциональность идентична. Разница только в том, насколько глубоко продукт интегрирован с остальной экосистемой компании.
Эта глава описывает AI Guard в первую очередь в формате самостоятельного продукта — потому что именно в таком виде он представляет наибольший интерес для крупных компаний, которые хотят начать с одной конкретной проблемы и не готовы сразу инвестировать в полноценную платформу. Однако всё, что описано ниже, применимо и к режиму встроенного модуля платформы.
9.2. Что закрывает AI Guard
Ложная дилемма корпоративного ИИ
При попытке внедрить ИИ в работу с корпоративными данными большинство компаний сталкивается с одной и той же дилеммой, которую часто формулируют как «либо безопасно, либо полезно». Один полюс — полный запрет ИИ на работу с любыми корпоративными данными. Это безопасно, но делает ИИ бессмысленным: модель не видит реальных данных, ответы не имеют отношения к корпоративному контексту, аналитика по корпоративному хранилищу невозможна. ИБ-блок превращается в «службу нет» — формально безопасен, фактически блокирует развитие.
Другой полюс — полный доступ без специальной защиты. ИИ полезен, но персональные данные клиентов уходят в облака LLM-провайдеров, нарушая ФЗ-152 и GDPR. Данные оказываются в руках вендора модели, иногда расположенного в другой юрисдикции. Автономные агенты могут тратить бюджет на токены без ограничений. Утечки происходят без следа в аудите. С точки зрения комплаенса этот полюс ещё хуже первого, потому что создаёт регуляторные риски.
Третий путь, который реализует AI Guard, — деперсонализация в разрыве. Это инженерное решение, в котором ИИ получает достаточно данных, чтобы быть полезным, но не получает персональных данных в открытом виде. Пользователь видит реальные данные, потому что они восстанавливаются на выходе. Модель работает только с токенами вместо ПД. Периметр компании персональные данные не покидают.
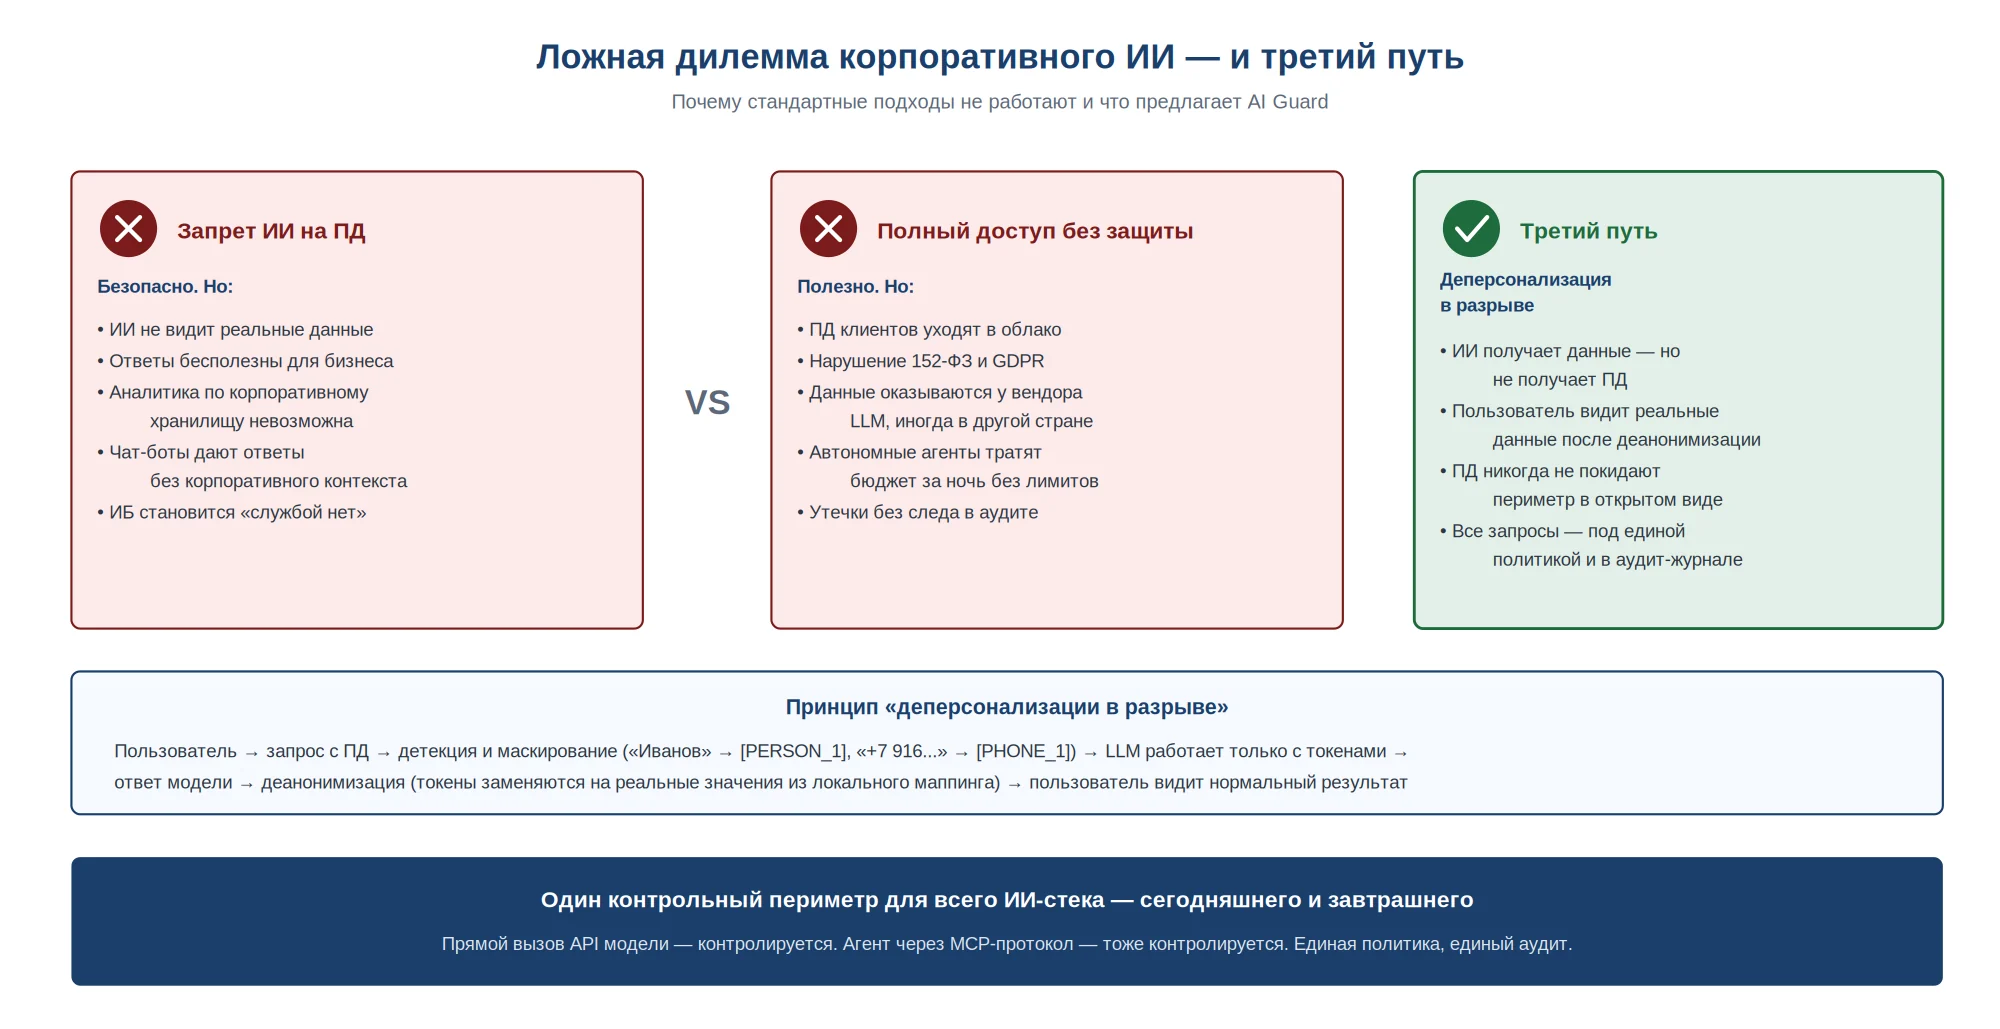
Что именно защищает AI Guard
AI Guard — программный комплекс защиты персональных данных при работе с языковыми моделями. Система перехватывает запросы к LLM-провайдерам, обнаруживает и маскирует ПД перед отправкой, и деанонимизирует ответы. Реальные данные никогда не покидают периметр организации в открытом виде. При этом продукт закрывает не только проблему ПД, но и три связанные задачи — управление трафиком к моделям, контроль расходов на inference и сквозной аудит обращений.
Первая задача — обеспечить соответствие требованиям к работе с персональными данными. AI Guard автоматически обнаруживает в запросах персональные сведения по 10+ категориям из коробки (ФИО, ИНН с проверкой контрольной суммы, СНИЛС, телефон, email, паспорт, номер счёта, номер карты, адрес и другие), а также по кастомным классам, которые добавляются ИБ-оператором через веб-интерфейс без участия разработчиков. Каждая обнаруженная сущность заменяется на нейтральный токен (например, «Иванов» становится [PERSON_1]) до отправки в модель. Ответ модели возвращается с обратной заменой токенов на реальные значения — пользователь видит нормальный результат, и эта работа происходит прозрачно.
Вторая задача — единая точка контроля для всего ИИ-стека. AI Guard работает не только с прямыми вызовами LLM через OpenAI-совместимый API, но и с агентским трафиком через протокол MCP (Model Context Protocol). Это означает, что ИБ-служба получает контроль над всем взаимодействием компании с языковыми моделями — независимо от того, инициировал ли запрос пользователь в чат-интерфейсе или автономный агент по своему расписанию. Политики, аудит, ограничения — единые.
Третья задача — финансовый контроль над расходами на inference. С появлением автономных агентов, которые могут совершать сотни и тысячи запросов в течение ночи без участия человека, расходы на ИИ перестают быть предсказуемыми. AI Guard задаёт квоты на токены на уровне каждого пользователя, агента, модели или провайдера. Это превращает ИИ-бюджет из «постфактумного открытия» в управляемую статью расходов с прогнозом и алертами.
Четвёртая задача — сквозной аудит. Каждое обращение к каждой модели фиксируется в журнале: кто запрашивал, какая модель отвечала, сколько ПД-сущностей было обнаружено, сколько токенов потрачено, какой результат. Это единая доказательная база как для аудита ИБ, так и для финансового контроля и расследования инцидентов.
Ключевые показатели
| Параметр | Значение |
|---|---|
| Задержка на обнаружение и маскирование ПД | менее 200 мс (p99) |
| Категории ПД из коробки (ФИО, телефон, email, паспорт, ИНН, счёт, карта…) | 10+ |
| Кастомные классы маскирования | без ограничений, настройка из UI |
| Поддерживаемые протоколы | OpenAI-compatible API, Anthropic API, MCP |
| Контроль токенов | на уровне пользователя, агента, модели, провайдера |
| Журналируется запросов | 100% |
| Потеря данных при сбое узла | 0 |
| Восстановление после сбоя узла | менее 30 секунд |
| Изменений в коде существующих приложений | 0 |
9.3. Механика одного запроса
Чтобы понять, как именно AI Guard обеспечивает заявленные характеристики, рассмотрим прохождение одного запроса от пользователя до получения ответа. Это критический поток системы, в котором определяется и производительность, и надёжность, и безопасность. Все компоненты на этом пути либо отрабатывают корректно — и пользователь получает ответ с реальными данными за заявленные миллисекунды; либо хотя бы один из критических компонентов недоступен — и запрос блокируется по принципу fail-closed, не достигая LLM-провайдера. Деградация в режим без анонимизации недопустима по определению.
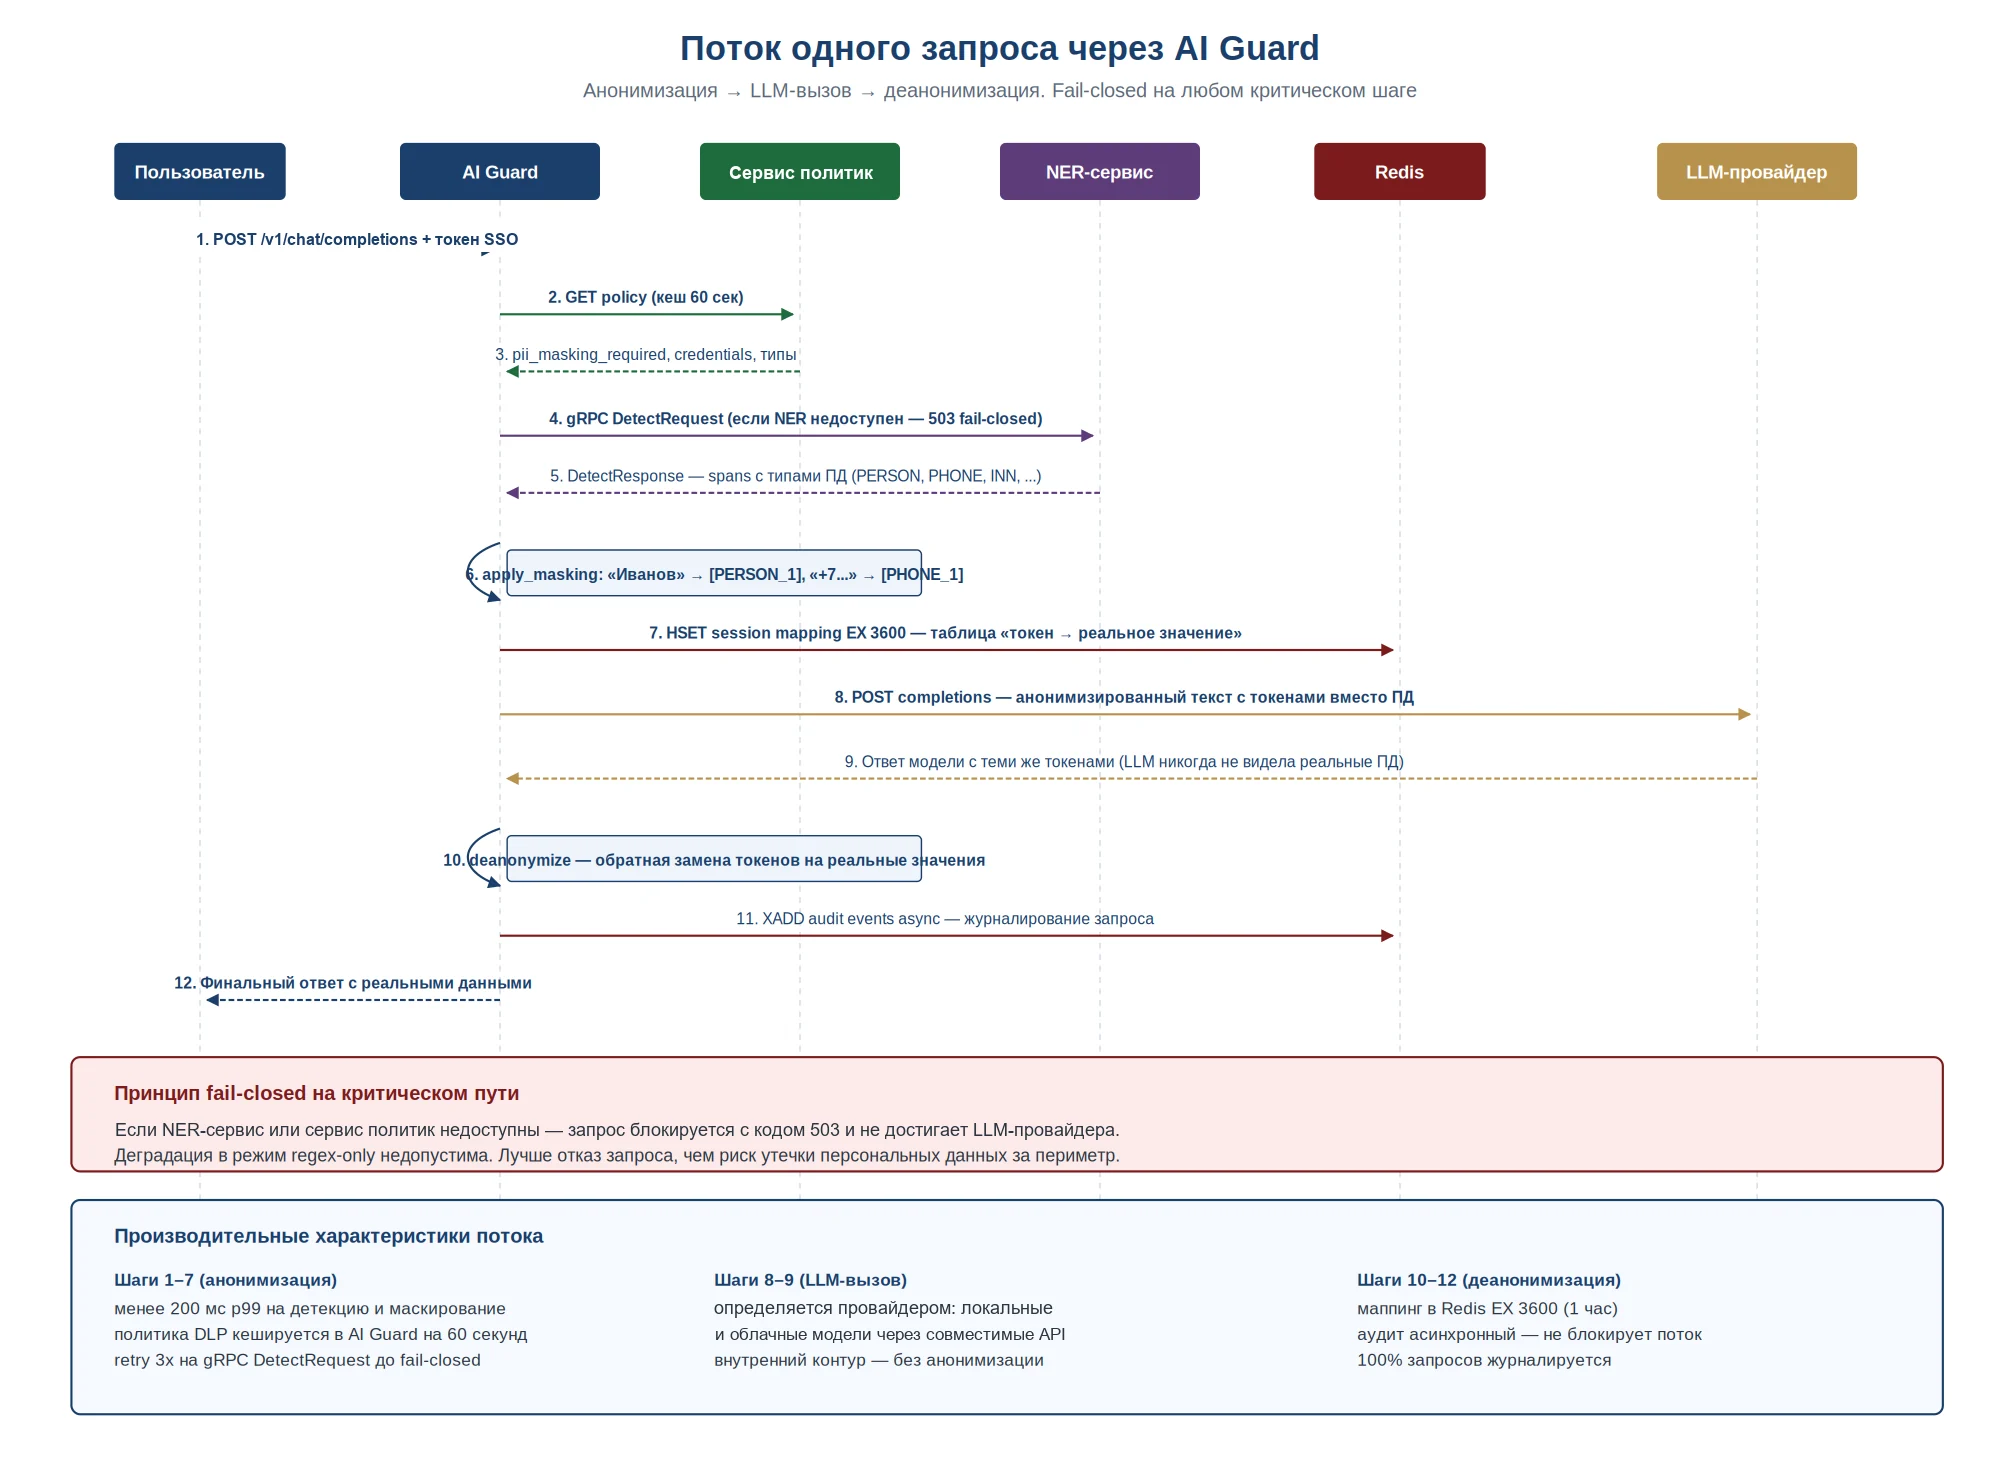
Этап 1. Приём и аутентификация запроса
Пользователь или приложение отправляет запрос на endpoint AI Guard. Запрос идёт по тому же протоколу, что и обычный вызов LLM — OpenAI-совместимый API, Anthropic API или MCP. Для существующих приложений, которые уже работают с LLM, это означает изменение только base_url в конфигурации — заменой одной строки. Никаких изменений в коде не требуется.
Сначала запрос принимает балансировщик nginx, выполняющий TLS termination и round-robin маршрутизацию на одну из реплик AI Guard API. Аутентификация запроса осуществляется через JWT-токен от каталога данных платформы — AI Guard не выпускает собственных токенов, а проксирует аутентификацию через корпоративный каталог пользователей. Это упрощает интеграцию с существующими системами SSO и снимает необходимость поддерживать ещё один каталог учётных записей.
Этап 2. Получение политики обработки
После аутентификации AI Guard запрашивает у сервиса политик актуальную политику для данного пользователя и целевой модели. Политика содержит ключевые параметры: требуется ли маскирование ПД для этой модели (для внутренних моделей — нет, для внешних — обязательно), какие типы ПД нужно маскировать в этом контексте, какие credentials использовать для аутентификации в LLM-провайдере, какие квоты применимы.
Чтобы не делать сетевой вызов на каждый запрос, политика кешируется в AI Guard на 60 секунд. Это компромисс между актуальностью (изменения в политике применяются с задержкой до минуты) и производительностью (большинство запросов работают без обращения к сервису политик). При изменении критичных политик кеш может быть инвалидирован принудительно.
Этап 3. Детекция персональных данных
Если политика требует маскирования, AI Guard отправляет содержимое запроса в NER-сервис через gRPC. NER (Named Entity Recognition) — отдельный сервис, реализованный на базе библиотек Natasha и Presidio с дополнительной донастройкой под русскоязычные финансовые контексты. Он возвращает массив обнаруженных сущностей с типами и координатами (spans) — например: «обнаружены ПД: PERSON в позициях 12-18, PHONE в позициях 45-58, INN в позициях 70-82 (контрольная сумма валидна)».
На этом этапе действует ключевой принцип fail-closed: если NER-сервис недоступен, запрос блокируется с кодом 503. Никакой деградации в режим regex-only или пропуска без обработки не допускается. Лучше отказ запроса, чем риск того, что необнаруженные ПД утекут к внешнему провайдеру. Это инженерное решение в пользу безопасности — и оно требует соответствующей надёжности NER-сервиса (горизонтальное масштабирование, retry, мониторинг).
Этап 4. Маскирование и сохранение маппинга
На основании ответа NER производится apply_masking: каждая обнаруженная сущность заменяется на токен соответствующего типа («Иванов Иван» становится [PERSON_1], «+7 916 123-45-67» становится [PHONE_1]). При этом строится таблица соответствия — какой токен означает какое реальное значение в рамках текущей сессии. Эта таблица сохраняется в Redis с TTL 3600 секунд (один час) — достаточно для длинных диалогов, но не настолько долго, чтобы хранить чувствительные данные дольше необходимого.
Этап 5. Вызов LLM-провайдера
Анонимизированный текст отправляется выбранному LLM-провайдеру через стандартный API. С точки зрения провайдера это обычный запрос — он не знает, что текст был обработан. Модель видит только токены и обычный окружающий контекст: «расскажи о клиенте [PERSON_1], номер договора [CONTRACT_1], сумма [AMOUNT_1]». На основании этого она генерирует ответ, в котором те же токены используются для обозначения тех же сущностей.
Этап 6. Деанонимизация и возврат
Ответ модели возвращается в AI Guard с теми же токенами. На этом этапе производится обратная замена — токены подставляются на реальные значения из локального маппинга в Redis. Пользователь получает нормальный ответ с реальными данными, и для него вся анонимизация прошла прозрачно. Параллельно событие записывается в audit-stream через XADD — асинхронно, чтобы не замедлять основной поток. Audit Service вычитывает поток и сохраняет события в PostgreSQL для последующего использования в аудите.
9.4. Архитектура решения
С точки зрения внутреннего устройства AI Guard — это распределённая система из нескольких типов компонентов, организованных в функциональные зоны. Все основные сервисы реализованы как stateless-реплики — состояние хранится не в памяти процессов, а в Redis. Это позволяет горизонтально масштабироваться, безопасно обновлять реплики без потери данных и переживать отказы отдельных узлов без последствий для пользователей.
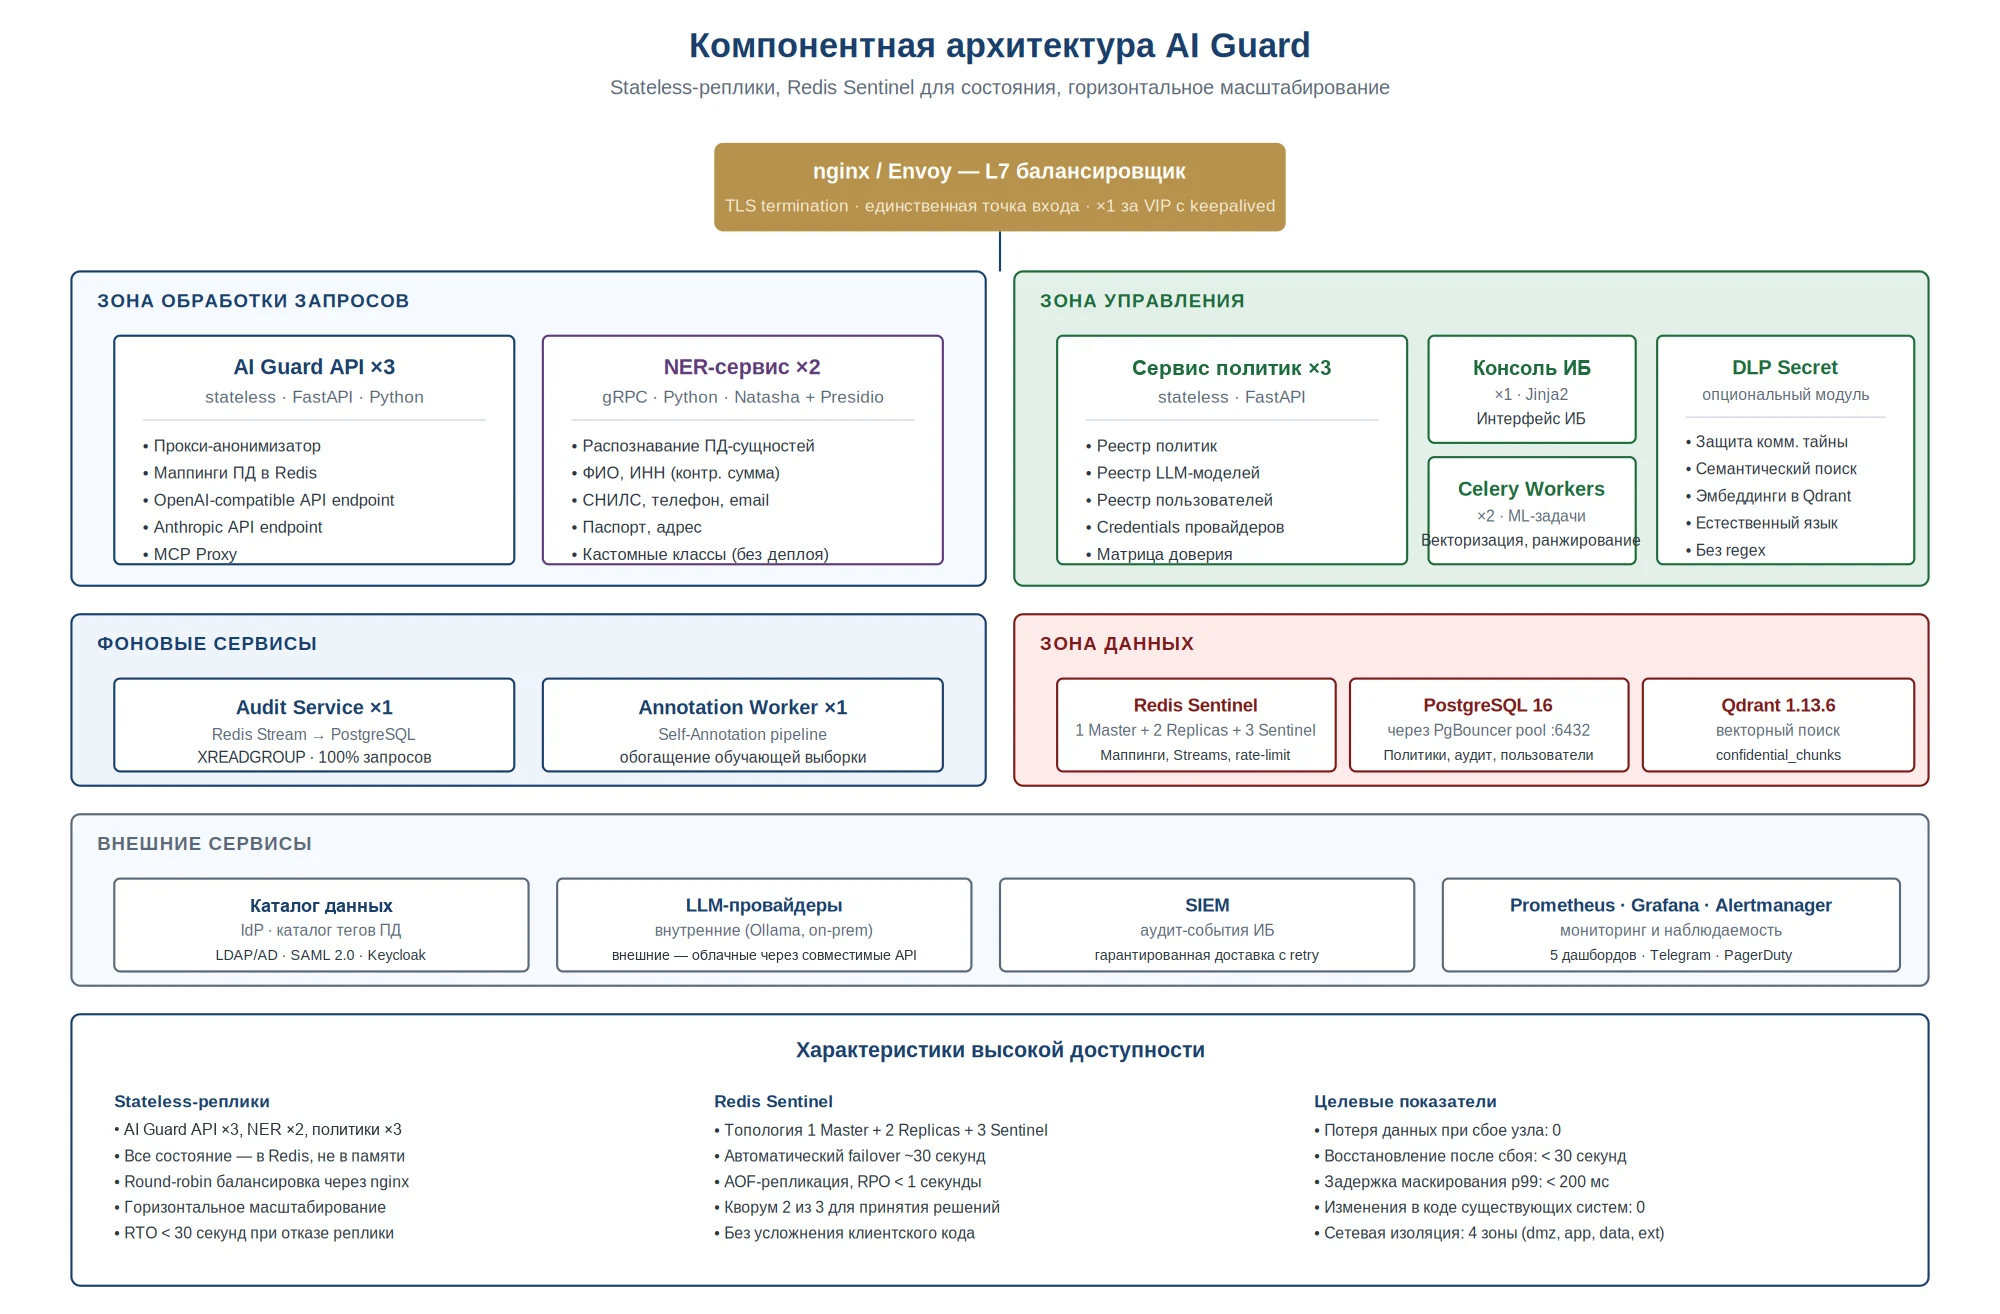
Зоны и компоненты
Зона обработки запросов
Эта зона обрабатывает основной трафик пользователей и приложений. Здесь живут AI Guard API (три реплики, FastAPI, stateless) и NER-сервис (две реплики, gRPC, стек Natasha + Presidio с донастройкой). AI Guard API — это публичные endpoint'ы, реализующие OpenAI-совместимый протокол, Anthropic API и MCP. NER-сервис — внутренний gRPC-сервис, отвечающий за распознавание ПД-сущностей. Обе компоненты горизонтально масштабируются: при росте нагрузки добавляются дополнительные реплики, балансировщик начинает направлять трафик на них автоматически.
Зона управления
Здесь сосредоточены сервисы конфигурации и политик. Сервис политик (три реплики, FastAPI) — реестр политик, реестр LLM-моделей, реестр пользователей и их прав, credentials для аутентификации в LLM-провайдерах, матрица доверия. Консоль ИБ (одна реплика, Jinja2) — веб-интерфейс для ИБ-оператора, через который происходит вся настройка системы. Celery Workers (две реплики) — фоновые ML-задачи, связанные с DLP Secret (векторизация секретов, переранжирование результатов поиска).
Опциональный модуль DLP Secret отвечает за защиту коммерческой тайны через семантический поиск. О нём подробно — в разделе 9.5.
Фоновые сервисы
Audit Service (одна реплика) непрерывно читает audit-stream в Redis и переписывает события в PostgreSQL для постоянного хранения. Это критический сервис для соответствия требованиям по аудиту — он обеспечивает, что 100% запросов попадают в долговременный журнал даже при высокой нагрузке на основной поток. Annotation Worker (одна реплика) реализует self-annotation pipeline — фоновое обогащение обучающей выборки для дальнейшего улучшения NER-моделей. В PostgreSQL попадают только замаскированные идентификаторы, не оригинальный текст с ПД.
Зона данных
Redis Sentinel — основное хранилище состояния. Топология «1 Master + 2 Replicas + 3 Sentinel» обеспечивает автоматический failover за ~30 секунд при отказе мастера. AOF-репликация гарантирует RPO менее 1 секунды. В Redis хранятся: таблицы соответствия токенов и реальных значений для активных сессий, audit-streams, счётчики rate-limit, celery-broker. Объём данных — единицы гигабайт, что позволяет использовать Sentinel вместо более сложного Cluster.
PostgreSQL 16 (внешний относительно периметра AI Guard, через PgBouncer pool) — основное реляционное хранилище. Здесь живут долгосрочные политики, аудит-журнал, реестр пользователей. Qdrant 1.13.6 — векторная база для DLP Secret (хранение эмбеддингов корпоративных секретов и семантический поиск по ним).
Внешние сервисы
Каталог данных платформы — корпоративный каталог пользователей и тегов данных. Используется как IdP (Identity Provider) для всех аутентификационных потоков и как источник тегов классификации данных. Поддерживаемые источники идентификации: встроенный Basic Auth (для демо-сред), LDAP/Active Directory (типовой для enterprise), SAML 2.0 (для интеграции с ADFS, Okta и другими IdP), Keycloak (self-hosted открытое решение).
LLM-провайдеры — разделены на два класса: внутренние (локальные модели в периметре компании) и внешние (облачные провайдеры через совместимые интерфейсы). Маршрутизация между классами определяется политикой и не может быть переопределена клиентским кодом.
SIEM — корпоративная система управления событиями ИБ. AI Guard формирует структурированные аудит-события и доставляет их в SIEM с гарантией: сначала событие записывается в PostgreSQL с флагом siem_sent=false, затем отправляется POST в SIEM. При ошибке доставки retry-worker повторяет попытку каждые 60 секунд до успеха. Это исключает потерю аудит-событий даже при временной недоступности SIEM.
Prometheus, Grafana и Alertmanager — мониторинговый стек. AI Guard экспортирует метрики в формате Prometheus, Grafana предоставляет пять специализированных дашбордов (поток запросов, latency LLM, NER-производительность, состояние Redis, состояние audit-pipeline), Alertmanager управляет алертами с маршрутизацией в Telegram, email и опционально PagerDuty.
Высокая доступность
Все основные компоненты горизонтально масштабируются и поддерживают автоматический failover. Целевые показатели восстановления:
| Компонент | RTO (Recovery Time Objective) |
|---|---|
| nginx (балансировщик с VIP keepalived) | менее 10 секунд |
| AI Guard API (×3 реплики, round-robin) | менее 30 секунд |
| NER-сервис (×2 реплики, gRPC failover, retry 3×) | менее 10 секунд |
| Сервис политик (×3 реплики, round-robin) | менее 30 секунд |
| Celery Workers (×2, Redis-backed queue) | менее 30 секунд |
| Redis (Sentinel auto-failover) | ~30 секунд, RPO < 1 секунды |
9.5. Многоуровневая защита
AI Guard реализует не один, а несколько уровней защиты, организованных как взаимодополняющие фильтры. Базовый уровень — детекция и маскирование персональных данных. Дополнительный (опциональный) уровень — DLP Secret, защита коммерческой тайны через семантический поиск. Над ними — политика, определяющая, как именно реагировать на обнаруженные сущности и в каких комбинациях разрешать передачу.
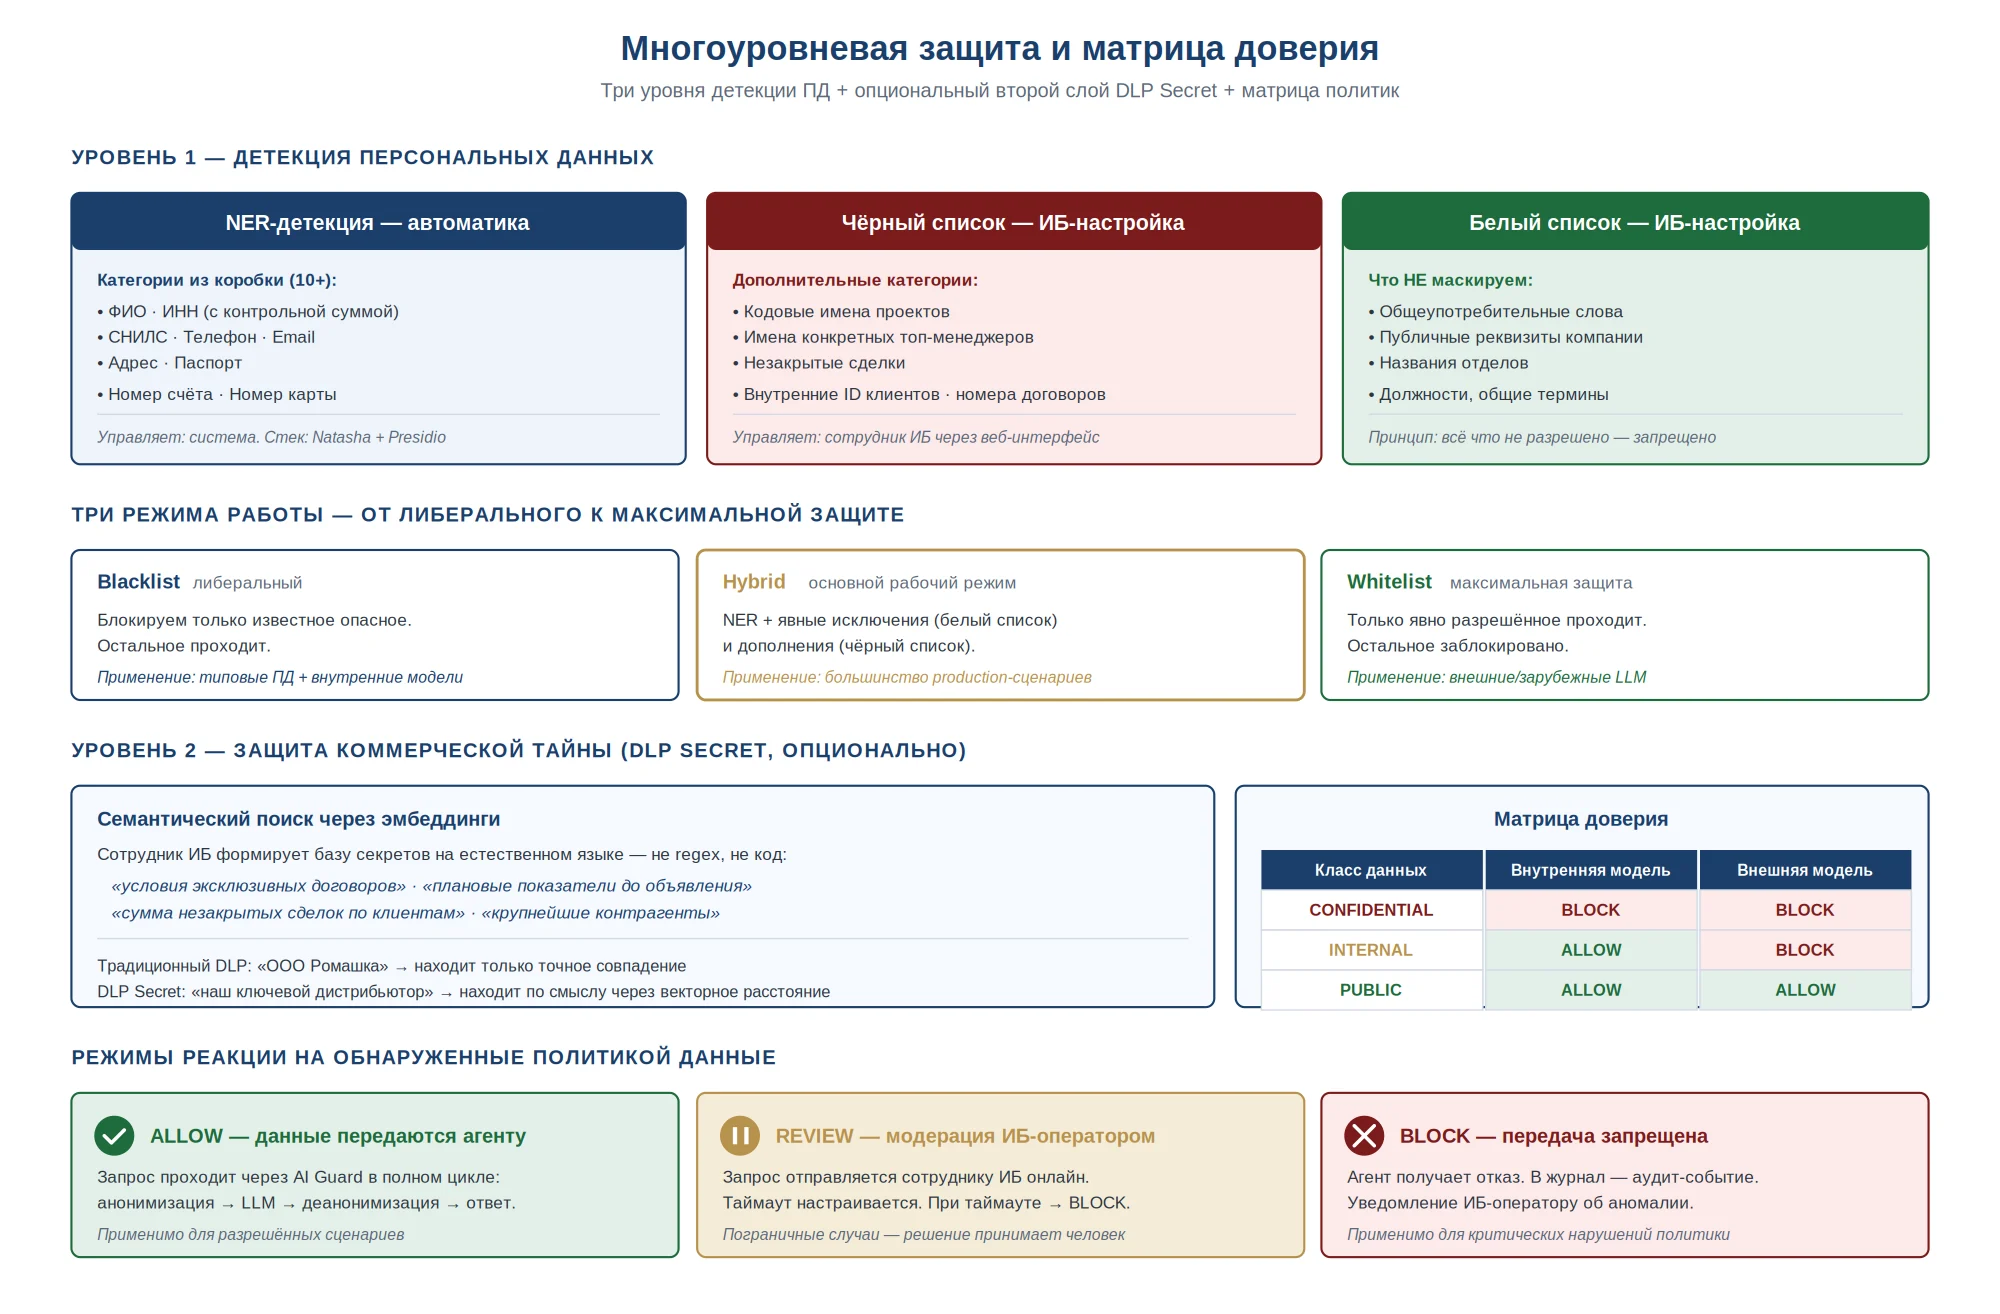
Уровень 1. Детекция персональных данных
Базовый уровень построен на трёх типах правил, работающих совместно. NER-детекция — автоматическая, на основе ML-моделей. Из коробки распознаются 10+ категорий: ФИО, ИНН (с проверкой контрольной суммы), СНИЛС, телефон, email, адрес, паспорт, номер счёта, номер карты. Распознавание учитывает русскоязычные особенности: например, «ИНН 770123456789» распознаётся не только по контексту, но и проверкой контрольной суммы — ложные срабатывания на 12-значных номерах, не являющихся ИНН, исключаются.
Чёрный список — ручная настройка ИБ-оператора. Сюда включаются дополнительные категории, специфичные для конкретной компании: кодовые имена внутренних проектов, имена топ-менеджеров (которые NER может не выделить как ПД, если они звучат «обычно»), названия незакрытых сделок, внутренние ID клиентов, номера договоров. Эти категории добавляются через консоль ИБ без участия разработчиков и без перезапуска сервисов.
Белый список — обратная настройка. Это явно разрешённые к передаче элементы, которые система не должна маскировать: общеупотребительные слова, публичные реквизиты самой компании (адрес офиса, телефон секретариата), названия отделов, должности, общие термины. Белый список применяется поверх NER и чёрного списка как исключение.
Три режима работы
В зависимости от чувствительности сценария и контура работы AI Guard может функционировать в одном из трёх режимов. Режим выбирается политикой DLP-Secret для каждой комбинации «пользователь × модель × тип данных».
| Режим | Применение |
|---|---|
| Blacklist — либеральный | Блокируем только известное опасное. Остальное проходит. Применимо: типовые ПД + внутренние модели |
| Hybrid — основной | NER + явные исключения (белый список) и дополнения (чёрный список). Применимо: большинство production-сценариев |
| Whitelist — максимум защиты | Только явно разрешённое проходит. Применимо: внешние и зарубежные LLM |
Уровень 2. DLP Secret — защита коммерческой тайны (опционально)
Второй уровень защиты — DLP Secret — решает задачу, которую NER в принципе решить не может: защиту коммерческой тайны. NER ищет данные с известной структурой (формат ИНН, шаблон телефона). Коммерческая тайна структуры не имеет — она определяется смыслом: что является секретным, решает компания, и это знание невозможно формализовать через regex или регулярный шаблон.
DLP Secret реализует семантический поиск через векторные эмбеддинги. Сотрудник ИБ формирует базу секретов через веб-интерфейс, описывая их на естественном языке — без regex, без кода: «условия эксклюзивных договоров», «плановые показатели до объявления», «сумма незакрытых сделок по клиентам», «крупнейшие контрагенты». При загрузке каждое описание преобразуется в эмбеддинг и сохраняется в Qdrant с присвоенным классом конфиденциальности (CONFIDENTIAL или INTERNAL).
При обработке запроса агента DLP Secret вычисляет эмбеддинг входящего текста и ищет ближайшие к нему элементы в Qdrant. Если запрос семантически близок к одному из зарегистрированных секретов, он классифицируется соответствующим классом. Это принципиально отличается от традиционного DLP, который работает по точному совпадению. Традиционный DLP, увидев «ООО Ромашка», находит только точные вхождения этой строки. DLP Secret, увидев «наш ключевой дистрибьютор», находит этот семантический паттерн в любом тексте, даже если конкретное название не фигурирует.
Матрица доверия и режимы реакции
Над уровнями детекции работает политика, которая определяет, что именно происходит при обнаружении тех или иных данных. Политика выражена через две оси: класс данных (CONFIDENTIAL / INTERNAL / PUBLIC) и тип модели (внутренняя / внешняя). На пересечении получается матрица доверия:
| Класс данных | Внутренняя модель → Внешняя модель |
|---|---|
| CONFIDENTIAL | BLOCK → BLOCK |
| INTERNAL | ALLOW → BLOCK |
| PUBLIC | ALLOW → ALLOW |
Решения матрицы реализуются через три режима реакции. ALLOW — данные передаются агенту в обычном цикле (анонимизация ПД при необходимости → LLM → деанонимизация → ответ). BLOCK — передача запрещена, агент получает отказ, в журнал записывается аудит-событие, ИБ-оператор получает уведомление об аномалии. REVIEW — пограничный случай: запрос отправляется сотруднику ИБ онлайн для модерации, таймаут настраивается, при отсутствии решения за таймаут — автоматический BLOCK. Это позволяет компании заранее не перекрывать все нестандартные сценарии, а оставлять человеческое решение для случаев на границе политики.
9.6. Интеграция и совместимость
Один из ключевых принципов AI Guard — нулевые изменения в коде существующих систем. Если у компании уже есть приложение, работающее с LLM, или агент, использующий MCP, или несколько ассистентов от разных вендоров, — все они должны продолжать работать после внедрения AI Guard, без переписывания и без перекомпиляции. Это достигается за счёт того, что AI Guard реализует те же протоколы, к которым уже привыкли существующие интеграции.
Поддерживаемые протоколы и провайдеры
Со стороны клиентов поддерживаются три протокола: OpenAI-compatible API (наиболее распространённый, де-факто стандарт для большинства LLM-сервисов), Anthropic API (для приложений, использующих этот формат), MCP — Model Context Protocol (для агентов, работающих с инструментами и контекстом). Любое приложение, говорящее на одном из этих протоколов, может быть переключено на AI Guard заменой одной строки в конфигурации — изменением base_url. Никаких изменений в коде, никакой адаптации SDK, никаких ребилдов.
Со стороны LLM-провайдеров поддерживаются российские облачные сервисы, локальные модели в периметре компании и любые OpenAI-совместимые провайдеры. Смена или добавление провайдера производится через консоль ИБ без перезапуска сервисов и без изменений в клиентских приложениях. Политика маршрутизации (какому пользователю какие модели доступны) задаётся отдельно от credentials, что упрощает ротацию ключей.
Аутентификация и единый каталог пользователей
AI Guard использует каталог данных платформы как единый каталог пользователей через SSO. Учётные записи не дублируются — управляются только в каталоге. Поддерживаются типовые корпоративные сценарии: LDAP/AD (наиболее распространённый в крупных российских компаниях), SAML 2.0 (для интеграции с корпоративными IdP — ADFS, Okta), Keycloak (для self-hosted открытых решений). Деактивация пользователя в каталоге автоматически прерывает все его активные сессии в AI Guard — централизованный logout без необходимости вручную инвалидировать токены.
Обработка разных форматов данных
| Формат | Как обрабатывается |
|---|---|
| SQL-результаты | Построчная обработка, diff (оригинал vs маскированное) сохраняется в audit-логе |
| Excel (.xlsx) | Обработка по ячейкам, структура таблицы, формулы и форматирование сохраняются |
| Word (.docx) | Обработка по абзацам, стили, заголовки и форматирование не нарушаются |
| Полная обработка текстового слоя. Изображения внутри PDF блокируются по умолчанию (защита от утечки сканов). OCR — в roadmap |
Дополнительный механизм — управляемая классификация через каталог данных. Колонке inn в таблице employees присваивается тег класса персональных данных в каталоге данных. AI Guard читает теги из каталога и применяет защиту по ним, а не угадывает по имени колонки. Новая таблица в системе — поставили тег — AI Guard автоматически защищает её. Это позволяет масштабировать защиту без изменений в коде и без новых деплоев.
9.7. Развёртывание и эксплуатация
Текущая конфигурация — Docker Compose
Текущая production-конфигурация работает на Docker Compose. Это сознательное решение: для большинства корпоративных развёртываний этого достаточно, а сложность Kubernetes не оправдана. Ниже — рекомендуемые ресурсы для типового развёртывания:
| Компонент | CPU / RAM / Disk |
|---|---|
| AI Guard API (×3 реплики) | 4 vCPU / 6 GB RAM / 10 GB |
| NER-сервис (×2 реплики) | 4 vCPU / 8 GB RAM / 5 GB |
| Сервис политик + Celery (×3) | 4 vCPU / 6 GB RAM / 10 GB |
| Redis Sentinel (3 ноды) | 2 vCPU / 4 GB RAM / 20 GB (AOF) |
| PgBouncer | 1 vCPU / 512 MB |
| Мониторинг (Prometheus, Grafana) | 2 vCPU / 4 GB RAM / 50 GB |
| ИТОГО на типовое развёртывание | ~17 vCPU / ~28 GB RAM / ~100 GB |
Kubernetes — roadmap
Для крупных развёртываний, где требуется автоматическое масштабирование под нагрузку и zero-downtime обновления, в плане поддержка Kubernetes. Архитектура к этому уже готова: stateless-реплики естественно превращаются в Deployment, конфигурация — в ConfigMap, credentials — в Secret, Redis с Sentinel — в StatefulSet с Sentinel endpoint. HPA (Horizontal Pod Autoscaler) будет настраиваться по метрике pii_requests_total. Для NER-сервиса — стратегия rolling update с параметрами maxUnavailable=0 и maxSurge=1, что обеспечивает обновления без потери доступности.
Сетевая изоляция
AI Guard устанавливается в четырёх логически разделённых сетях с разными правилами доступа:
| Сеть | Участники и правила |
|---|---|
| dmz | nginx и клиенты. Только входящий трафик на 443/80 |
| app | шлюз безопасности, классификатор персональных данных и тайны, распознавание сущностей. Взаимодействие между сервисами |
| data | redis, pgbouncer, qdrant. Доступ только из app, не из dmz |
| ext | Исходящие соединения к LLM-провайдерам. Только из шлюза безопасности |
Эта изоляция критична для соответствия требованиям ИБ-блока. В частности, факт того, что зона data недоступна из dmz, означает, что даже компрометация nginx не даёт прямого доступа к Redis с маппингами ПД.
9.8. Мониторинг, аудит и SIEM-интеграция
Метрики и алерты
AI Guard экспортирует расширенный набор метрик в формате Prometheus. Ключевые метрики, по которым настраиваются алерты:
| Метрика | Сигнал тревоги |
|---|---|
| pii_requests_total | Резкое падение → проблема в балансировщике |
| pii_llm_latency_seconds (p99) | Более 5 секунд → проблема у LLM-провайдера |
| ner_detect_latency_seconds (p99) | Более 500 мс → перегрузка NER, нужно добавить реплики |
| ner_cache_hit_ratio | Менее 0.3 → много уникальных строк, NER работает в режиме холодного запуска |
| redis_connected_slaves | Менее 2 → потеря реплики, возможен сбой Sentinel |
| audit_stream_lag | Более 1000 → Audit Service отстаёт, риск потери аудит-событий |
Grafana предоставляет пять специализированных дашбордов, покрывающих все аспекты эксплуатации: общий поток запросов, состояние LLM-провайдеров, производительность NER, состояние Redis Sentinel, состояние audit-pipeline. Alertmanager управляет правилами эскалации и маршрутизирует алерты в Telegram, email и (опционально) PagerDuty.
SIEM-интеграция с гарантированной доставкой
Сервис политик формирует структурированные аудит-события по каждому действию оператора и каждому критическому системному событию. События доставляются в SIEM с гарантией: сначала событие записывается в PostgreSQL с флагом siem_sent=false, затем выполняется POST в SIEM. При успехе флаг переключается в true. При ошибке retry-worker повторяет попытку каждые 60 секунд до успеха. Это исключает потерю событий даже при временной недоступности SIEM.
Классы аудит-событий покрывают полный спектр действий, представляющих интерес для ИБ:
| Класс событий | Примеры событий и severity |
|---|---|
| Управление доступом | user_blocked, model_deactivated → warning |
| Credentials | credentials_updated, api_key_rotated → warning |
| Политики | pii_policy_changed, masking_bypass_enabled → info |
| Аутентификация | login_success, login_failed, user_synced → info |
| Аномалии | config_hash_mismatch, ner_service_unavailable → critical |
9.9. Связь с архитектурой ИИ-слоя
AI Guard не существует в отрыве от общей логики корпоративного ИИ-слоя, описанной в главах 3–4. Чтобы было ясно, где именно он закрывает работу, вернёмся к чек-листу из главы 3 (восемь ключевых вопросов внедрения) и шести возможностям ИИ-слоя из главы 4.
AI Guard прямо закрывает вопрос 2 (как защищаем чувствительное) — это его центральная функция. Дополнительно закрывает вопрос 5 (ролевая модель), потому что наследование прав из корпоративного каталога встроено в его архитектуру. Частично закрывает вопрос 6 (контроль расходов на inference) через систему квот и счётчиков. Также вносит вклад в вопрос 7 (эксплуатация) через интеграцию с SIEM и наблюдаемость.
В терминах шести capabilities ИИ-слоя из главы 4, AI Guard — это полная реализация capability 3 (Безопасность и ролевая модель) и значительная часть capability 1 (AI Gateway и оркестрация), поскольку выполняет функцию единой точки маршрутизации, авторизации и контроля квот для всех LLM-запросов. Это означает, что внедрение даже одного AI Guard (без остальной платформы) уже закрывает 2 из 6 базовых capabilities — что для многих компаний достаточно как первый шаг.
Глава 10
Внешний офис ИИ — операционный инструмент перехода
Главы 8 и 9 описали продукты — платформу «Камерата» и Камерата AI Guard. Но продукты сами себя не внедряют: между «у нас есть инструменты» и «у нас работает корпоративная ИИ-практика» лежит большой и плохо формализуемый промежуток. Эту главу мы посвящаем тому, как этот промежуток закрывается — через формат, который мы называем Внешним офисом ИИ. Это не услуга и не проектное предложение, а функциональный инструмент перехода компании по карте зрелости из главы 7. В главе мы фиксируем формат команды, разворачиваем одиннадцать ролей, которые она может играть, и показываем, какая роль уместна на каком этапе зрелости заказчика.
10.1. Где Внешний офис в нашей логике
В предыдущих главах документа мы последовательно зафиксировали: как должно быть устроено (главы 3–4), какие двусторонние эффекты это даёт бизнесу и ИТ (глава 5), как организован конвейер инициатив (глава 6), какая карта зрелости описывает движение компании к целевому состоянию (глава 7), какие продукты реализуют целевую архитектуру (главы 8–9). Все эти элементы — необходимые. Но ни один из них сам по себе не делает компанию более зрелой в работе с ИИ. Платформа без команды, которая её настроит, — это набор контейнеров. Карта зрелости без человека, который проведёт по ней дорогу, — это таблица в PDF. Конвейер без методолога, который внедрит его как операционный процесс, — это диаграмма в презентации.
Реальное движение от «Хаоса» к «Управляемому» и далее к «Зрелому» уровню требует не только продуктов и идей, но и людей, которые их применят к конкретной компании, к её ИТ-ландшафту, к её процессам, к её ограничениям. У компании есть три способа достать этих людей. Первый — нанять в штат: правильный долгосрочный путь, но медленный и упирающийся в кадровый рынок (опытных AI-архитекторов на рынке мало, конкуренция за них высокая). Второй — нанять консультантов, которые подскажут «как надо»: быстро, но не приводит к результату, потому что советы не равны внедрению. Третий — пригласить функциональную команду, которая на ограниченный срок становится частью компании и руками делает работу. Этот третий путь мы называем Внешним офисом ИИ.
Принципиально важно понимать, что Внешний офис — не услуга в традиционном смысле. Услуга предполагает фиксированную задачу с понятным ТЗ — например, «сделать пилот X» или «разработать ИИ-агента Y». Внешний офис устроен иначе: это команда с набором функций, из которых компания выбирает те, что нужны именно сейчас, в зависимости от текущего уровня зрелости. Одна и та же команда у одной компании работает как «архитектор безопасного периметра», у другой — как «методолог конвейера», у третьей — как «production-пилотировщик». Меняется не команда, меняется роль, которую она играет.
10.2. Формат команды
С организационной точки зрения Внешний офис — это компактная прикладная ИИ-команда, которая работает с компанией ограниченный срок в продуктовом формате. Состав команды формируется под конкретные задачи, но костяк типового формата включает несколько фиксированных ролей.
Состав команды
В стандартный состав Внешнего офиса входят: AI-архитектор (он же тимлид), ML/AI-инженер, full-stack или интеграционный инженер, бизнес-аналитик (на part-time), проектный менеджер (на part-time). Это пять-шесть человек суммарно с разной долей участия. Команда формируется под задачу: если фокус на построение платформы — больше инженерных ресурсов; если на методологию — больше аналитики и проектного управления; если на адаптацию моделей под отраслевую специфику — добавляется ML-специалист с релевантным опытом.
AI-архитектор — ключевая роль команды. Это человек, который видит картину целиком: где сейчас компания на карте зрелости, какие capabilities нужно построить, в каком порядке, какие технологии и провайдеры выбрать, как соединить новые ИИ-элементы с существующим ИТ-ландшафтом. От его насмотренности и опыта зависит, придёт ли работа Внешнего офиса к нужному результату — или превратится в очередной набор разрозненных пилотов.
Остальные роли — исполнительные: ML-инженер строит и адаптирует модели, full-stack/интеграционный инженер соединяет это с существующими корпоративными системами, бизнес-аналитик переводит идеи бизнеса в технические требования и обратно, проектный менеджер следит за сроками и коммуникацией. В разных компаниях и при разных типах работ соотношение нагрузки на роли меняется.
Принципы работы
Первое — Внешний офис работает в продуктовом, а не проектном формате. Это означает: фокус на ценности, измеримой бизнес-метрикой, а не на закрытии формальной задачи. Если за две недели работы выясняется, что начальная гипотеза была ошибочной, команда не «доделывает то, что записано в плане», а возвращается к заказчику с новой формулировкой. Регулярные демонстрации промежуточных результатов вместо толстых отчётов в конце.
Второе — минимум бюрократии. Не толстые ТЗ, не многослойные согласования, не недели на разработку проектной документации перед стартом. Команда запускается за неделю-две, начинает работать на реальных данных в реальных системах в первый же месяц. Это означает определённый уровень доверия к команде со стороны заказчика — потому что часть решений принимается «на ходу», без формальных утверждений. Этот формат подходит не всем компаниям и не всем сценариям, но для большинства задач Внешнего офиса он оказывается оптимальным.
Третье — передача знаний как обязательная часть работы. Команда уходит, и важно, чтобы после её ухода компания не вернулась к прежнему состоянию. Поэтому в каждой работе встроен компонент передачи: документация, обучение внутренней команды, регламенты, ритуалы. Это превращает Внешний офис из «команды-наёмника» в катализатор внутренних изменений.
10.3. Одиннадцать ролей в четырёх фазах работы
Конкретные функции, которые Внешний офис играет в работе с заказчиком, мы группируем в одиннадцать ролей, последовательно проходящих через четыре фазы. Последовательность фаз отражает естественный путь работы: диагностика того, где компания сейчас, потом построение базовой инфраструктуры, потом внедрение операционной модели, потом запуск прикладных сценариев. Не каждая компания идёт по всем фазам, и не каждая роль обязательна — но порядок именно такой: невозможно построить процесс без инфраструктуры, и бессмысленно строить инфраструктуру без понимания, куда компания идёт.

Фаза 1. Диагностика
Роль 1. Аудитор зрелости и автор дорожной карты
Первая роль, которую Внешний офис играет в работе с компанией. Команда приходит не с готовым предложением «давайте сделаем вам пилот», а с инструментом — картой зрелости из главы 7. Совместно с заказчиком (ИТ-блок, бизнес-владельцы, ИБ-блок) проходит по каждой строке карты и фиксирует, где компания сейчас. По итогам у заказчика появляется срез: где компания сильна, где отстаёт, где есть несоответствие представлений между блоками компании.
На основе этой диагностики формируется дорожная карта перехода — какие конкретные действия нужны для движения на следующий уровень, в каком порядке, с какими сроками и зависимостями. Это превращает теоретическую карту зрелости в адресный план изменений именно для этой компании. Часто эта роль заказывается как самостоятельный короткий формат: компания не покупает «всё сразу», а сначала понимает, что именно ей нужно. По нашему опыту, это правильная первая инвестиция — она экономит существенно больше, чем стоит, за счёт того, что компания дальше тратит ресурсы прицельно, а не распыляет на «всё подряд».
Фаза 2. Базовая инфраструктура
Роль 2. Архитектор безопасного периметра
По нашему опыту работы с крупными российскими компаниями, эта роль чаще всего становится первой реальной — той, в которой Внешний офис начинает физическую работу с инфраструктурой заказчика. Причина простая: безопасность — самая блокирующая проблема внедрения ИИ в крупной компании. Пока ИБ-блок не согласовал работу ИИ-систем с корпоративными данными, никакие пилоты, никакие архитектуры, никакие методологии не запускаются.
В этой роли Внешний офис внедряет AI Guard (глава 9), настраивает политики безопасности под специфику компании (классы данных, матрицу доверия, режимы реакции), обучает ИБ-операторов работе с веб-интерфейсом, помогает пройти внутренний аудит и комплаенс. Артефакт на выходе — работающий безопасный периметр и согласованные политики, с которыми ИБ-блок может работать самостоятельно. Это закрывает вопросы 2 (как защищаем чувствительное) и 5 (ролевая модель) из чек-листа главы 3.
Роль 3. Платформенный builder
Когда у компании есть стратегическое решение строить корпоративный ИИ-слой как описано в главе 4, но нет команды, которая может это сделать руками, — Внешний офис приходит как инженерная сила. Не «консультирует, как надо», а собирает платформу: разворачивает AI Gateway, настраивает корпоративные знания и поиск, выстраивает governance, организует мониторинг, выбирает варианты развёртывания (on-premise, облако, гибрид) под политики компании.
Эта роль обычно занимает несколько месяцев и требует наибольшего вовлечения команды. Артефакт на выходе — работающий ИИ-слой с реализованными базовыми capabilities из главы 4 и одним-двумя production-сценариями, запущенными на этой инфраструктуре. Важно понимать, что речь идёт не о внедрении готового коробочного продукта в чистом виде, а об инженерной адаптации под конкретный ИТ-ландшафт заказчика: какие интеграции с системами-источниками, какие LLM-провайдеры под какие сценарии, какие политики маршрутизации, какие принципы развёртывания. Эта адаптация — основная инженерная работа Внешнего офиса в роли builder'а.
Роль 4. Стабилизатор существующих ИИ-проектов
Часто Внешний офис приходит в компанию, где уже есть несколько ИИ-сценариев — внедрённых в разное время, разными командами, на разных стеках. Это типовая картина «зоопарка пилотов» (проблема 6 из главы 2): что-то работает на ChatGPT через прокси, что-то на GigaChat, что-то — на коробочном ассистенте от стороннего вендора. У каждого решения свои данные, свои доступы, свой контроль. Через год компания обнаруживает, что не может ответить даже на простой вопрос «сколько мы тратим на ИИ и какой получаем эффект».
В этой роли Внешний офис проводит инвентаризацию существующих ИИ-инициатив, оценивает их зрелость, закрывает технический долг, восстанавливает мониторинг и аудит, мигрирует наиболее перспективные сценарии на общую инфраструктуру (если она построена), останавливает заведомо нежизнеспособные. На выходе компания получает не «всё работает идеально», а ясную картину — что есть, что стоит развивать, что закрыть, и единый портфель управляемых ИИ-сценариев вместо неуправляемого зоопарка.
Фаза 3. Операционная модель
Роль 5. Методолог конвейера + внедрение инструмента управления
После того как базовая инфраструктура построена, возникает следующий вопрос: как организовать поток работы — от идеи бизнеса до production-сценария. Это и есть та самая операционная модель, которую мы описали в главе 6 как «конвейер ИИ-инициатив». В этой роли Внешний офис материализует конвейер из теоретической концепции в работающий процесс: формирует регламенты прохождения стадий, организует архитектурные комиссии, определяет точки принятия решений, проводит первые «прогоны» новых идей через стадии конвейера.
Принципиальная часть этой роли — внедрение инструмента управления ИИ-инициативами. Это аналог Jira или другого issue-tracker'а, но заточенный под специфику ИИ-портфеля: каждая инициатива имеет владельца от бизнеса, гипотезу эффекта, текущую стадию конвейера, бизнес-метрики, статус по ИБ-аудиту, оценку требуемых данных и моделей, фактические затраты на inference. Инструмент позволяет руководству в любой момент видеть портфельную картину, а ИТ и бизнес — координироваться вокруг конкретных инициатив. Без такого инструмента «конвейер» остаётся декларацией. С ним — превращается в наблюдаемый процесс.
Роль 6. FinOps и model routing
Параллельно с построением операционной модели возникает финансовое измерение работы ИИ: расходы на inference, стоимость каждого сценария, прогнозирование затрат на год. На раннем этапе зрелости (Хаос) эта тема обычно игнорируется — счёт от провайдеров приходит постфактум, и его кое-как объясняют задним числом. По мере роста объёмов это становится недопустимым: расходы могут вырасти в десятки раз за квартал, и без управления компания обнаруживает себя с бюджетом, который не объяснить.
Внешний офис в этой роли внедряет инфраструктурные элементы финансового контроля: AI Gateway как единую точку учёта запросов, маршрутизацию между моделями по правилу «дешёвая модель на простую задачу, мощная — на сложную», квоты на уровне команд и пользователей, прогноз затрат на следующий период. Артефакт на выходе — переход от «счёта постфактум» к «предиктивным квотам» из карты зрелости. Бизнес-эффект: ИИ-бюджет становится управляемой статьёй с прогнозируемостью, а не «постфактумным открытием».
Роль 7. Vendor manager
LLM-провайдеры — это рынок с быстро меняющимися условиями: появляются новые игроки, меняются тарифы, выходят новые модели с лучшими характеристиками или худшими ограничениями. Компании, у которой нет собственной насмотренности в этом рынке, легко сделать неоптимальный выбор: подписаться на дорогую модель там, где справилась бы дешёвая, или наоборот — попытаться сэкономить там, где экономия выйдет боком.
Внешний офис в роли vendor manager'а помогает заказчику ориентироваться в этом рынке: оценить реальные характеристики моделей разных провайдеров (а не маркетинговые), посчитать unit-экономику конкретных сценариев под разные модели, провести переговоры о тарифах при значимых объёмах, выбрать сочетание провайдеров под разные политики (внутренние/внешние, чувствительные/публичные). Эта роль особенно ценна в первый год работы с ИИ — когда у компании ещё нет своей экспертизы. Дальше эта функция постепенно переходит во внутреннюю команду.
Роль 8. Создатель внутреннего Центра компетенций
Финальная роль операционной фазы. Она не про «обучить команду», а про другое: сформировать в компании функциональную единицу, которая после ухода Внешнего офиса самостоятельно поддерживает и развивает ИИ-практику. Это не курс с сертификатами на выходе, а построенная структура: с регламентами работы, ритуалами (архитектурные комиссии, разборы инцидентов, ретроспективы), метриками (зрелость, эффект, расходы), процессом развития сотрудников.
Внешний офис в этой роли передаёт не знания (хотя и знания тоже), а способность воспроизводить процессы. Аудитор, builder, методолог — это люди извне, делающие работу. Центр компетенций — это уже внутренняя команда заказчика, которая после передачи может сама запускать новые сценарии, сама пересматривать политики, сама договариваться с провайдерами, сама пересматривать дорожную карту. Это и есть конечная цель Внешнего офиса: чтобы через какое-то время он перестал быть нужен.
Фаза 4. Применение и сценарии
Роль 9. Генератор и фильтр ИИ-инициатив
Эта роль работает на самой ранней стадии конвейера из главы 6 — стадии «Идея от бизнеса». Часто бизнес знает, что хочет «что-то с ИИ», но не знает, что именно. Или знает, но формулирует через моду — «давайте сделаем чат-бот, потому что у конкурентов есть», без понимания, какую конкретную проблему это решает и какой экономический эффект даст.
Внешний офис в этой роли помогает бизнесу формулировать содержательные идеи: проводит интервью с владельцами процессов, анализирует, где в их работе есть рутина и узкие места, предлагает гипотезы сценариев, формализует ожидаемый эффект. Параллельно работает второй функцией — на стадии «Архитектурная оценка» отсекает идеи, которые технически нереализуемы или экономически бесперспективны. Это защищает компанию от инвестиций в провальные проекты до того, как они запущены. По опыту, эта фильтрация снимает 30–50% начальных идей — но оставшиеся имеют существенно более высокий шанс дойти до эффекта.
Роль 10. Production-пилотировщик
Эта роль реализует стадию 3 конвейера — «Пилот на платформе». Принципиальное отличие от типовых пилотов в незрелой инфраструктуре: пилот делается не «в песочнице, чтобы потом переписать», а сразу на правильной архитектуре. Если в компании построен ИИ-слой (роль 3) — пилот собирается из готовых capabilities этого слоя. Если построены только отдельные элементы инфраструктуры (например, безопасный периметр от роли 2) — пилот строится на этих готовых элементах, не дублируя их.
Это означает, что переход от стадии 3 (пилот) к стадии 4 (промышленная эксплуатация) не требует значительной переработки — пилот изначально работает в правильном контуре, с правильной безопасностью, с правильным мониторингом. Внешний офис в этой роли не делает «демо-пилот», который выглядит красиво, но не доходит до прода. Он делает первую итерацию production-сценария, которая после демонстрации эффекта естественно переходит в эксплуатацию.
Роль 11. Адаптатор моделей под отраслевую специфику
Для большинства сценариев достаточно коробочных моделей и стандартных настроек. Но в отраслях с собственной терминологией и спецификой — банкинг, медицина, юриспруденция, страхование — стандартные модели работают хуже, чем могли бы. NER, обученный на общих корпусах, плохо распознаёт специфические сущности (например, банковские продукты или медицинские термины). Embedding-модели общего назначения дают не оптимальное семантическое расстояние на отраслевых текстах. Это снижает точность сценариев, иногда до уровня, когда они становятся неприменимы.
Внешний офис в этой роли проводит адаптацию моделей под закрытый корпус заказчика: fine-tuning NER под отраслевую терминологию, подбор и донастройка embedding-моделей под специфические тексты, валидация точности на реальных данных, итеративное улучшение. Это глубоко техническая работа, требующая специализированной экспертизы. Она оправдывается на том масштабе, где базовая точность моделей уже не устраивает, а готовых отраслевых решений на рынке нет или они не подходят по условиям комплаенса.
10.4. Когда какая роль уместна
Одиннадцать ролей — это слишком много, чтобы заказывать «всё сразу». На практике компания выбирает, какие роли нужны именно сейчас, в зависимости от того, на каком уровне зрелости она находится и куда хочет идти. Карта ниже показывает, на каком переходе по карте зрелости (из главы 7) каждая роль приоритетна, а где избыточна.
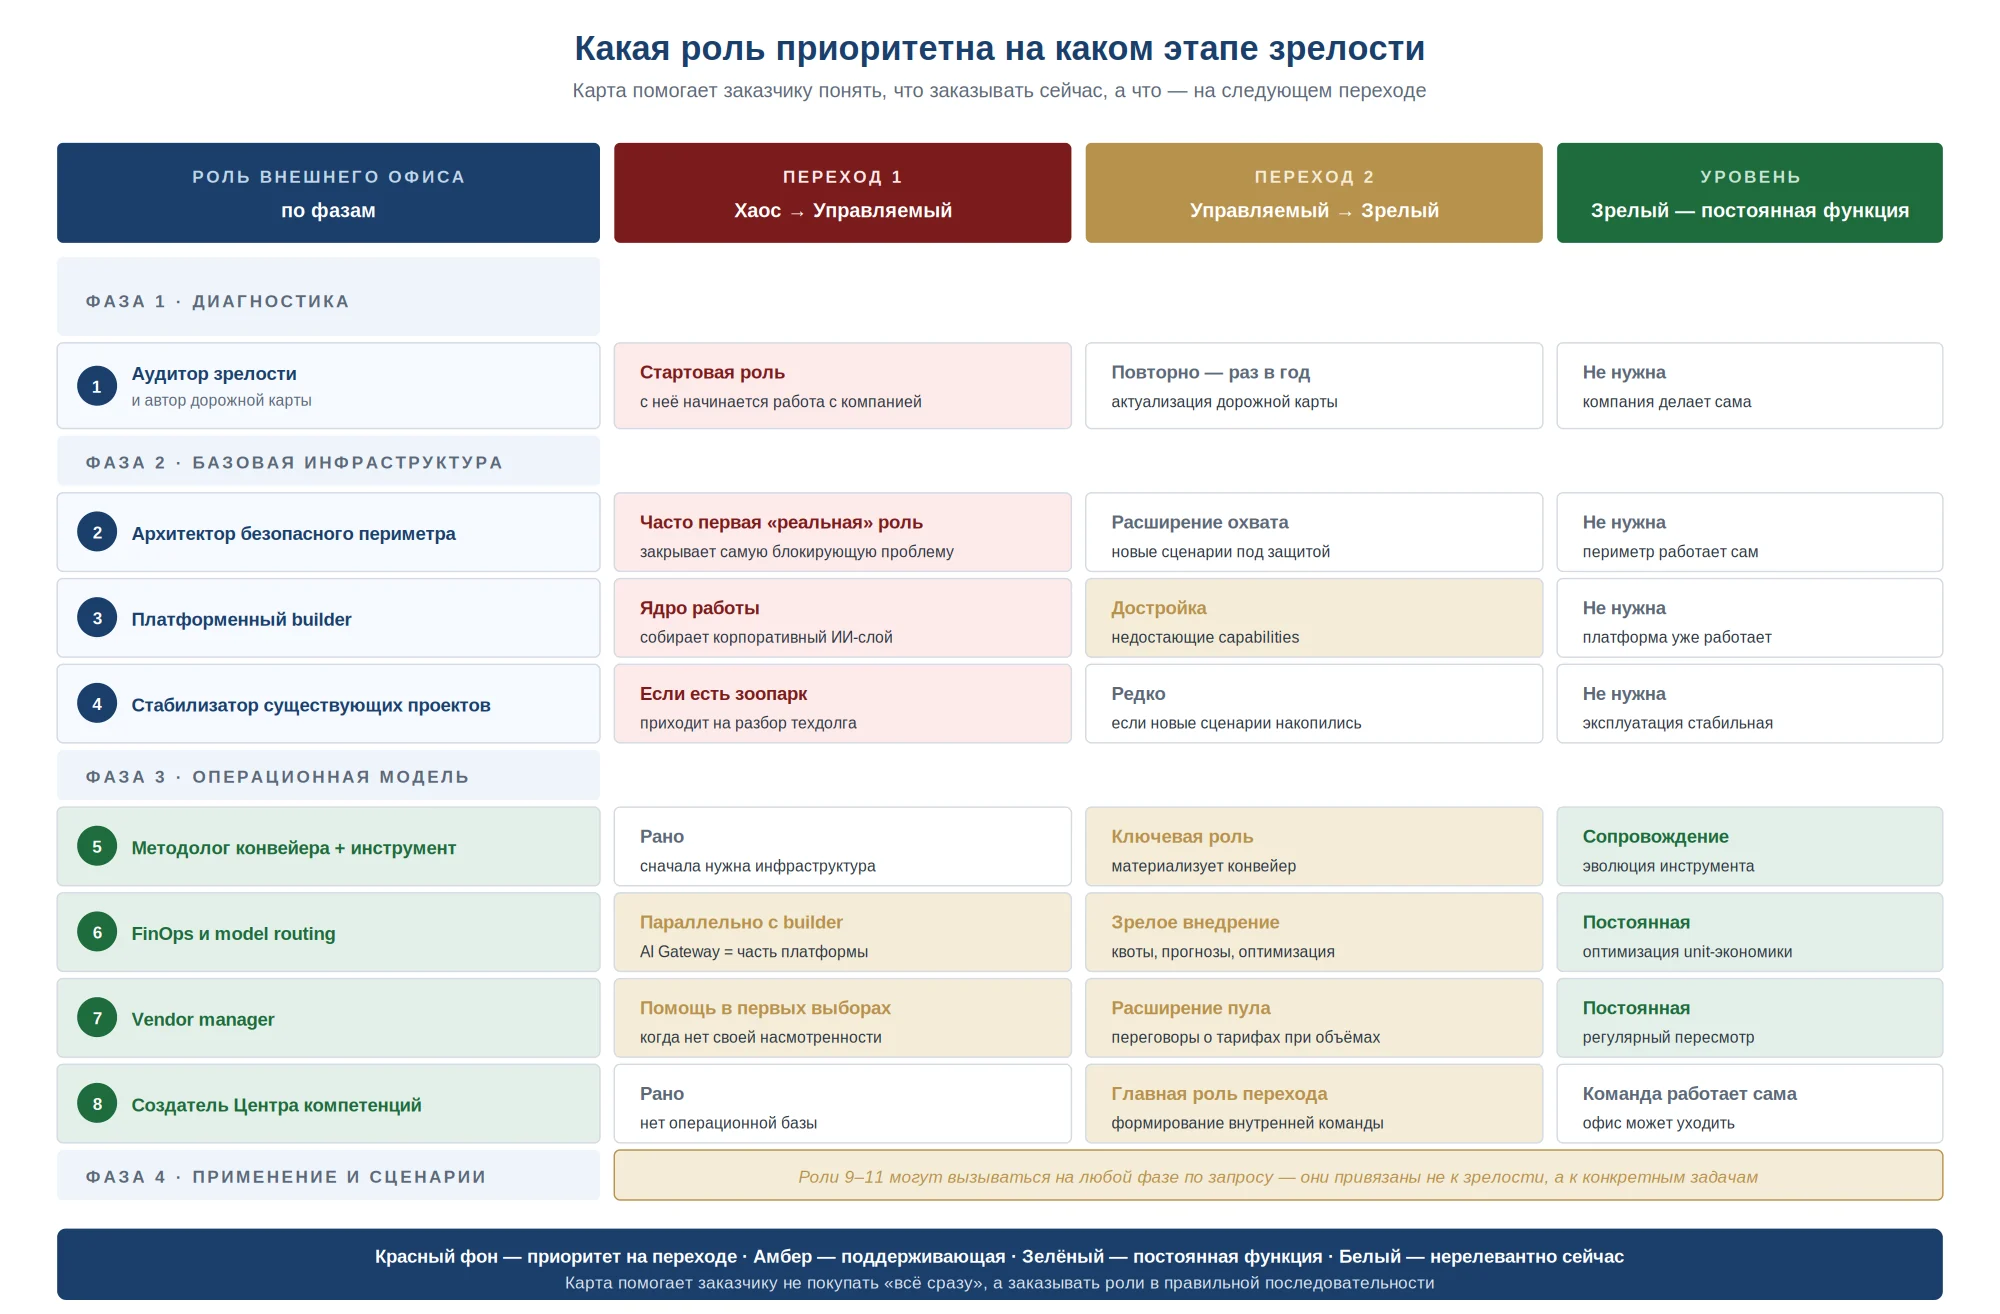
Из карты следует несколько практических наблюдений. На переходе «Хаос → Управляемый» приоритетны роли первых двух фаз: диагностика (1), базовая инфраструктура (2, 3, 4). Это понятно: компания, которая ещё не имеет ни безопасного периметра, ни платформы, не выиграет от попыток сразу настроить методологию или vendor management — для них пока нет основания. Сначала строится инфраструктура, потом на ней — процессы.
На переходе «Управляемый → Зрелый» центр тяжести смещается на операционную модель: методология конвейера (5), FinOps (6), vendor management (7), центр компетенций (8). Базовая инфраструктура к этому моменту уже работает, и задача — превратить разрозненную работу с ИИ в управляемую корпоративную практику. На уровне «Зрелый» Внешний офис в большинстве ролей не нужен — компания работает самостоятельно. Постоянными остаются только функции, связанные с внешним рынком (FinOps и vendor management) — там полезно иметь внешний взгляд на меняющиеся условия.
Роли четвёртой фазы — генератор инициатив (9), production-пилотировщик (10), адаптатор моделей (11) — устроены иначе. Они привязаны не к уровню зрелости, а к конкретным задачам. Сценарии запускаются и на этапе «Хаос» (если есть пилот, который надо сделать «правильно»), и на «Управляемом», и на «Зрелом». Адаптация моделей может потребоваться в любой момент, когда возникает специфический отраслевой кейс. Эти роли — отдельный режим работы с Внешним офисом, не связанный с фазами построения инфраструктуры.
10.5. Чем Внешний офис отличается от консалтинга и от штатной команды
В заключение полезно зафиксировать различия Внешнего офиса от двух соседних форматов, с которыми его часто путают.
От консалтинга Внешний офис отличается тем, что не даёт рекомендаций «как надо», а делает работу руками. Консультант приносит презентацию с дорожной картой и оставляет компанию её внедрять самостоятельно. Внешний офис — это та самая команда, которая внедряет. Все одиннадцать ролей из этой главы — это роли исполнителей, а не советчиков. Это принципиальное различие: рекомендации легко получить и часто легко проигнорировать; работающий результат игнорировать нельзя.
От штатной команды Внешний офис отличается ограничением во времени и фокусом на передаче. Штатная команда — это постоянная структура внутри компании, развивающаяся вместе с ней годами. Внешний офис приходит на конкретный этап, закрывает разрыв и уходит — оставив после себя инфраструктуру, процессы и внутреннюю команду, способную работать дальше. Это означает, что Внешний офис не конкурирует со штатной командой, а создаёт условия для её появления и роста. Часто работа Внешнего офиса как раз и заключается в том, чтобы помочь компании сформировать собственную ИИ-команду — это и есть содержание роли 8 (Центр компетенций).
Зафиксировав форматы и роли Внешнего офиса, мы подходим к последнему элементу нашего подхода — обучению и адаптации сотрудников компании к работе с ИИ. Это тема следующей главы.
Глава 11
Обучение и стратегические сессии
Главы 8–10 описали инструменты и команду, которые компания использует, чтобы построить корпоративную ИИ-практику: платформу, защищённый периметр, внешнюю инженерную команду. Но ни одна инфраструктура и ни одна команда не дают эффекта, если в самой компании люди не понимают, что они с этим делают. Эта глава — о четвёртой практике, без которой остальные три работают не в полную силу: об обучении и стратегических сессиях. Мы не предлагаем «провести курс по ИИ» — мы описываем обучение как функцию, которая меняет своё содержание по мере того, как меняется уровень зрелости компании.
11.1. Зачем глава про обучение в документе про инфраструктуру
Документ, который вы читаете, — про инфраструктуру и операционную модель ИИ в крупной компании. На первый взгляд, обучение здесь выглядит инородно: это вроде бы не про инженерные решения и не про архитектуру. Но именно практика работы с заказчиками показывает обратное. Самая зрелая платформа не даёт эффекта, если её пользователи не понимают, для каких задач она предназначена. Самые сильные политики ИБ не работают, если ИБ-операторы не умеют ими управлять. Самый аккуратный конвейер инициатив пуст, если бизнес не знает, какие идеи имеет смысл туда подавать.
Это не «приятное дополнение» к технике — это её обязательное условие. По нашему опыту, компании, которые на старте отказываются от обучения как от «излишества» в пользу «сначала сделаем платформу, потом подумаем», стабильно повторяют одну и ту же ошибку: через шесть-двенадцать месяцев у них работает платформа, на которой никто не работает. Не потому, что платформа плохая, а потому, что никто внутри компании не научился её использовать.
Поэтому мы выделяем обучение в отдельную практику и описываем его в одной серии с платформой, AI Guard и Внешним офисом. Не как разовое мероприятие в начале проекта, а как функцию, которая сопровождает компанию на всём пути её движения по карте зрелости. Содержание этой функции меняется: на «Хаосе» она про знакомство, на «Управляемом» — про массовую практику, на «Зрелом» — про автономность. Именно эту динамику мы разворачиваем в этой главе.
11.2. Три уровня обучения по карте зрелости
В главе 7 мы описали карту зрелости с тремя уровнями: «Хаос», «Управляемый», «Зрелый». На каждом уровне у компании принципиально разный запрос к обучению. Если ответить на этот запрос не тем форматом — обучение получится формальным и не приведёт к изменению практики. Поэтому первое, что нужно сделать перед тем, как проектировать программу — определить, на каком уровне зрелости находится компания и что именно ей сейчас требуется.

Уровень «Хаос». Запрос: «А что такое ИИ вообще?»
На этом уровне типовая ситуация выглядит так. У руководства есть смутное ощущение, что «надо что-то делать с ИИ» — потому что про это говорят на отраслевых конференциях, потому что у конкурентов появились пилоты, потому что про это спрашивают акционеры. Но конкретного понимания нет: что такое ИИ применительно к нашему бизнесу, какие задачи им вообще можно решать, с чего начинать, что покупать, как считать эффект. Это не «непонимание из лени» — это реальная ситуация почти всех компаний, у которых ещё нет производственной ИИ-практики.
В этой ситуации не имеет смысла сразу обсуждать архитектуру или строить дорожную карту. Сначала нужно сформировать общее понимание — у топ-менеджмента, у руководителей ключевых функций, у ИТ-блока, у ИБ-блока. Без этого общего понимания любое решение принимается на основе случайных представлений, и компания идёт по случайной траектории.
Цель обучения на этом уровне — дать общую картину рынка ИИ, сформировать единый словарь между блоками компании, помочь увидеть применимость к собственному бизнесу. Основной формат — стратегическая сессия для топ-менеджмента продолжительностью один-два дня. К ней могут добавляться обзорные воркшопы для функций — короткие сессии, где руководители функций знакомятся с тем, как ИИ применим конкретно у них. Содержательный материал — карта AI-инструментов, каталог сценариев отраслевых применений, разбор экономики типовых сценариев.
Главная аудитория — CEO, правление, директора по технологиям, данным, информации, цифровизации, руководители ключевых функций. Это люди, которые будут принимать решения о финансировании ИИ-инициатив, выделении команд, выборе провайдеров. Без их общего понимания эти решения принимаются вслепую. Результат — единое понимание ландшафта, первичный список гипотез о том, где ИИ может дать эффект конкретно в этой компании, готовность к следующему шагу: диагностике зрелости и формированию дорожной карты.
Уровень «Управляемый». Запрос: «Как научить команды этим пользоваться?»
На этом уровне у компании уже работает базовая инфраструктура — платформа, безопасный периметр, какие-то сценарии в эксплуатации. У руководства есть понимание ландшафта и есть стратегия. Возникает следующий вопрос: как добиться того, чтобы реальное использование ИИ стало массовым, а не оставалось уделом небольшой группы энтузиастов. Без обучения этого не происходит — даже если инструменты доступны всем.
Запрос на этом уровне принципиально другой. Не «расскажите, что такое ИИ» (это уже понятно), а «научите наши команды конкретно работать с ним в их повседневных задачах». Это переход от стратегического обучения к прикладному. Аудитория тоже сдвигается: это не правление и не CxO, а руководители функций, их замы, ключевые сотрудники, операторы платформы, ИБ-операторы.
Цель обучения на этом уровне — передать практические навыки работы с инструментами и платформой, встроить ИИ в рабочие процессы команд. Содержание становится максимально предметным: конкретные интерфейсы, конкретные кейсы из практики этой команды, работа на реальных задачах, разбор типовых ошибок. Основные форматы — прикладные воркшопы по функциям, обучение операторов платформы, подготовка ИБ-операторов к работе с инструментами безопасности, регулярные тематические сессии для обмена опытом, внутренние «AI office hours» — открытые встречи, где сотрудники могут принести свои задачи и получить совет.
Результат — команды реально используют ИИ в своих процессах. Это видно по числу запросов к платформе, по портфелю инициатив, который пополняется снизу, по реальным изменениям в скорости выполнения типовых работ. На этом уровне обучение становится не разовым мероприятием, а постоянной функцией: новые сотрудники должны проходить обучение при приёме, новые инструменты — при их выходе, изменения в политиках — при их введении.
Уровень «Зрелый». Запрос: «Как развивать практику самостоятельно?»
На этом уровне у компании уже сформирован внутренний Центр компетенций по ИИ (роль 8 Внешнего офиса из главы 10), который самостоятельно поддерживает и развивает практику. Запрос к внешнему обучению меняется радикально: компания больше не нуждается во внешних обучающих программах массового характера — она обучает себя сама. Внешнее обучение становится точечным: продвинутые модули по специализированным темам, обмен опытом с другими компаниями отрасли, экспертиза в узких областях, где собственной не хватает.
Цель обучения на этом уровне — сформировать и развивать внутреннее тренерское ядро, развивать продвинутые компетенции (fine-tuning моделей, специализированные технические темы, экспертиза в конкретных отраслевых применениях), обеспечивать рост портфеля сценариев за счёт собственных ресурсов. Основные форматы — программы «train the trainer» для внутренних тренеров, продвинутые модули по запросу, сертификация ключевых ролей, точечное привлечение внешних экспертов под конкретные темы, внутренние конференции и обмен между функциями.
Результат — компания не зависит от внешних обучающих программ для массового обучения. Когда появляется новый сотрудник, его обучают внутри. Когда выходит новый инструмент, внутренние тренеры адаптируют его под практику компании. Когда возникает специализированная задача, привлекается внешний эксперт — точечно, по конкретной теме, без необходимости «общего обучения по ИИ».
11.3. Форматы обучения и их аудитории
На каждом уровне зрелости задействован свой набор форматов. Полный спектр форматов, которые мы используем, — семь основных, каждый под свою аудиторию. Один и тот же содержательный материал не подходит правлению и рядовым сотрудникам, ИБ-операторам и пользователям платформы. Поэтому при проектировании программы первое, что определяется — какой формат для какой аудитории.
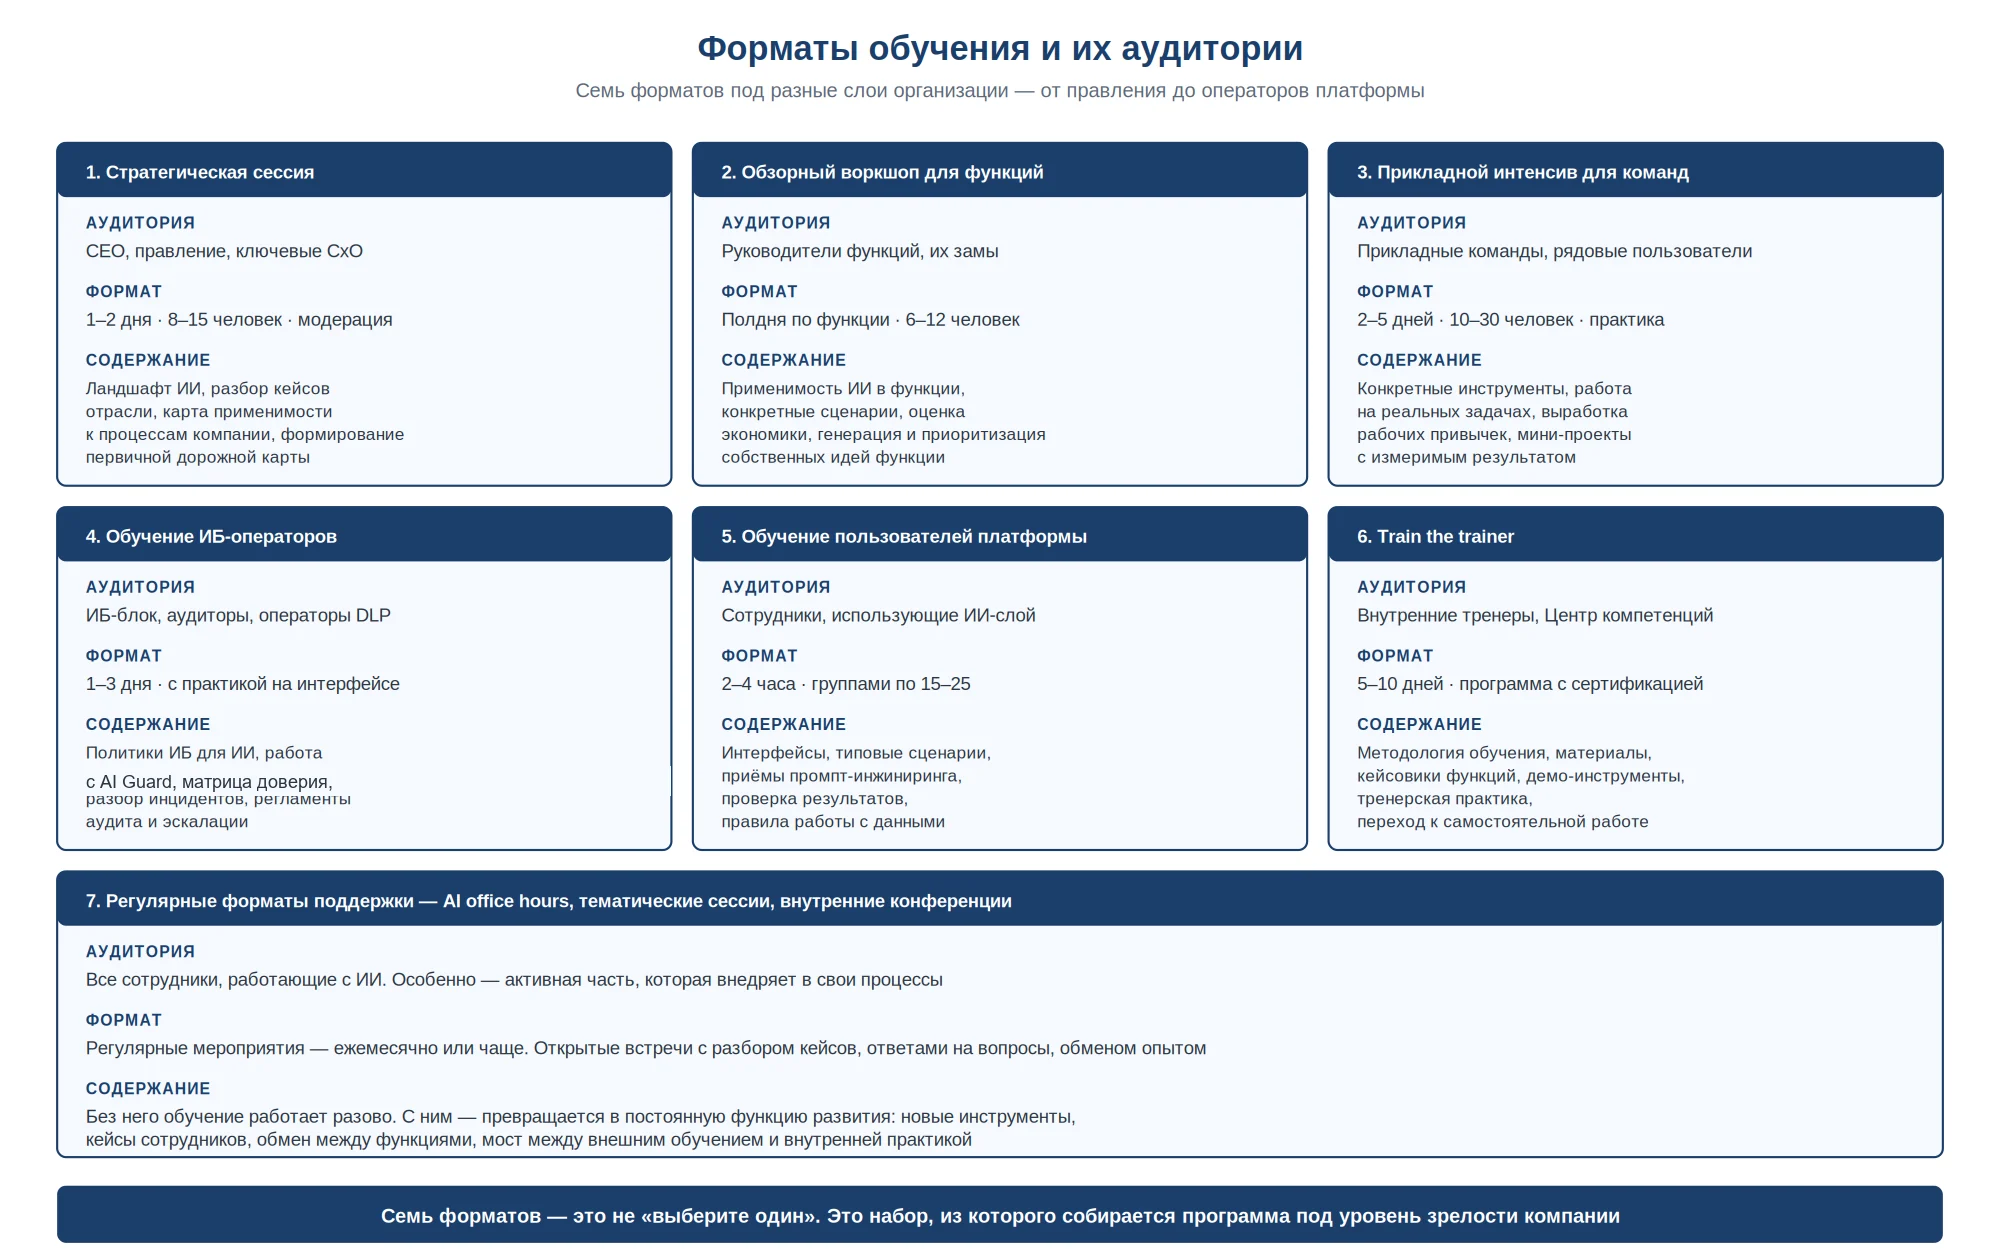
Стратегическая сессия
Формат для топ-менеджмента — CEO, правления, ключевых CxO. Продолжительность один-два дня, группа 8–15 человек, обязательно с модерацией. Цель — не «провести лекцию», а провести продуктивную дискуссию: разобрать ландшафт ИИ, посмотреть на кейсы своей отрасли, обсудить применимость к процессам компании, в конце сессии сформировать первичную дорожную карту. Хорошо проведённая стратегическая сессия — это сессия, в которой топ-менеджмент в первый раз обсуждает ИИ не как абстракцию, а как конкретный набор решений с понятной экономикой и понятными требованиями.
Обзорный воркшоп для функций
Формат для руководителей функций и их замов — финансов, HR, продаж, маркетинга, юристов, операций и так далее. Продолжительность полдня по функции, группа 6–12 человек. Содержание прикладное: применимость ИИ в конкретной функции, разбор типовых сценариев именно для этой функции, оценка экономики, генерация и приоритизация собственных идей. Результат воркшопа — список первоочередных гипотез функции, которые можно подавать в конвейер инициатив.
Прикладной интенсив для команд
Формат для прикладных команд и рядовых пользователей — тех, кто будет использовать ИИ в повседневной работе. Продолжительность от двух до пяти дней, группа 10–30 человек, основной упор на практику. Содержание — конкретные инструменты, работа на реальных задачах команды, выработка рабочих привычек, мини-проекты с измеримым результатом. Это самый трудоёмкий формат, но и самый ценный: после него люди не «знают про ИИ», а реально его используют.
Обучение ИБ-операторов
Формат для ИБ-блока, аудиторов, операторов DLP-систем. Продолжительность один-три дня, обязательно с практикой на интерфейсе. Содержание — политики ИБ для ИИ, работа с AI Guard, матрица доверия, разбор типовых инцидентов, регламенты аудита и эскалации. Без этого формата ИБ-блок справедливо блокирует расширение использования ИИ — потому что не уверен в своей способности это контролировать. С ним — становится не препятствием, а партнёром в развитии практики.
Обучение пользователей платформы
Формат для сотрудников, которые используют корпоративный ИИ-слой в работе. Продолжительность два-четыре часа, группами по 15–25 человек. Содержание — интерфейсы платформы, типовые сценарии, приёмы промпт-инжиниринга, проверка результатов, правила работы с разными классами данных. Это самый массовый формат и обычно проводится регулярно — для новых сотрудников и при выходе новых функций платформы. На зрелом уровне ведётся в основном силами внутреннего Центра компетенций.
Train the trainer
Формат для внутренних тренеров и Центра компетенций. Продолжительность пять-десять дней, программа с сертификацией. Содержание — методология проведения обучения, материалы и каталоги сценариев, демо-инструменты, тренерская практика, постепенный переход от обучения с внешним наставником к самостоятельной работе. Это формат, который превращает компанию из заказчика внешнего обучения в самообучающуюся организацию. По нашему опыту, инвестиция в этот формат окупается быстрее всех остальных — потому что после него компания перестаёт каждый раз платить за обучение новых сотрудников из внешнего источника.
Регулярные форматы поддержки
Формат не разовый, а постоянный: AI office hours, тематические сессии, внутренние конференции, обмен кейсами между функциями. Аудитория — все сотрудники, работающие с ИИ, особенно активная их часть, которая внедряет инструменты в свои процессы. Содержание формируется по запросу: разбор новых инструментов, обсуждение кейсов сотрудников, ответы на вопросы, обмен опытом между функциями. Это та самая «функция, которая сопровождает компанию» — без неё обучение остаётся разовым событием, с ней — превращается в постоянное развитие.
11.4. Содержательные блоки обучения
Независимо от формата и уровня, обучение опирается на конечный набор содержательных блоков. Они адаптируются под аудиторию и глубину, но базовые темы остаются теми же — потому что отражают логику работы с ИИ в крупной компании.
Карта AI-инструментов
Систематизированный обзор семейств ИИ-инструментов: универсальные LLM, AI-поиск и research, корпоративный поиск (RAG), ИИ-агенты, no-code и vibe-coding инструменты, мультимодальные инструменты (изображения, видео, аудио, аватары), инструменты для встреч и транскрибации. Для каждого семейства — типовые применения, сильные и слабые стороны, ограничения, типовые риски. Этот блок даёт аудитории навигацию: на что вообще способен современный ИИ-стек, какие классы инструментов решают какие задачи.
Каталог сценариев функций
Подборка практических сценариев применения ИИ для каждой функции компании — CEO, ИТ, ИБ, финансы, HR, юристы, продажи, маркетинг, операции, риски и другие. По каждой функции — список из 8–15 типовых задач, где ИИ может дать быстрый эффект, с примерами инструментов под каждое применение. Этот блок переводит абстрактные возможности ИИ в конкретные сценарии: «вот что именно вы можете начать делать у себя в отделе».
Логика выбора инструмента
Методика того, как выбрать правильный класс инструмента под задачу. Принцип не «от бренда», а «от процесса, данных, риска и ожидаемого эффекта». Что улучшаем, какие данные используем, какой контур требуется, нужна ли интеграция с системами, действие или только подсказка, кто проверяет результат, какой эффект измеряем. Эта методика снижает риск того, что компания выберет «модный инструмент», который не подходит под её задачу.
Экономика ИИ-применений
Как считать эффект от внедрения ИИ. Формула «частота операции × время на операцию × стоимость времени × изменение качества», практика оценки unit-экономики, разбор типовых заблуждений (например, ожидание полного замещения экспертов вместо реалистичной картины «сокращение времени подготовки на 30–50%»). Этот блок защищает от завышенных ожиданий и помогает реалистично планировать инвестиции.
Безопасность и контур использования
Базовая классификация данных и их допустимости в разных контурах: открытые / обезличенные / внутренние / чувствительные / регулируемые. Принципы human-in-the-loop: что ИИ может готовить, за что отвечает человек. Связь с AI Guard и политиками безопасности компании. Этот блок особенно важен в крупных компаниях с регулируемыми данными — без него любое внедрение ИИ упирается в законное беспокойство ИБ-блока.
Методология запуска инициатив
Как идея бизнеса превращается в работающий сценарий. Конвейер из главы 6: идея → архитектурная оценка → пилот → промышленная эксплуатация → метрики и развитие. Кто что делает на каждой стадии. Как формулировать гипотезу. Как считать эффект. Как принимать решение о продолжении или остановке. Этот блок особенно важен для обучения функциональных команд — потому что превращает их идеи из «обсудим когда-нибудь» в управляемый процесс.
11.5. Когда обучение работает, а когда — нет
Обучение — самая «мягкая» из четырёх практик, и поэтому одновременно самая уязвимая к формальному отношению. По нашему опыту, успех или неудача обучающей программы определяется не качеством материалов и не уровнем спикеров (хотя и они важны), а несколькими организационными условиями. Когда эти условия выполнены, программа меняет реальную практику. Когда не выполнены — даже самая блестящая программа остаётся «приятным мероприятием», после которого ничего не меняется.
Условие 1. У программы есть владелец
Самое частое условие, которое нарушается. «Давайте проведём обучение по ИИ» — без указания, кто внутри компании отвечает за результат. После такого обучения участники возвращаются на свои рабочие места, и через две недели всё забывается, потому что никто не возвращает к нему. С владельцем — другая история: владелец сопровождает участников после сессии, отслеживает, кто что начал применять, помогает преодолеть первые препятствия, докладывает руководству о результатах.
Условие 2. Привязка к реальным задачам компании
Обучение на абстрактных примерах усваивается плохо. Обучение на реальных задачах компании усваивается сразу. Поэтому хорошая программа всегда начинается со сбора задач: от участников до сессии, от их руководителей, от ИТ-блока. На сессии разбираются именно эти задачи, а не общие иллюстрации. После сессии у каждого участника есть один-два конкретных сценария, которые он собирается попробовать у себя.
Условие 3. Измеримый эффект
Через месяц после программы должно быть понятно, изменилось ли что-то в работе обученных команд. Что измеряем — определяется до программы, вместе с заказчиком. Это может быть число запросов к платформе, число запущенных в конвейер инициатив, время выполнения типовых работ, доля сотрудников, реально использующих ИИ в повседневной работе. Без таких метрик обучение остаётся «галочкой в плане HR» — что бы ни говорили на сессии.
Условие 4. После-обучающее сопровождение
Одно из главных открытий нашей практики: программа без сопровождения работает в 3–5 раз хуже программы с сопровождением. После основной программы обязательно идёт период сопровождения — короткие follow-up сессии, ответы на вопросы, разбор первых попыток применения, помощь в преодолении конкретных препятствий. Этот период должен быть запланирован и оплачен заранее, иначе он не происходит.
Условие 5. Связь с другими практиками
Обучение не существует в вакууме. Оно работает только в связи с инфраструктурой (что обсуждаем — на чём пробуем), с командой (кто помогает реализовать после обучения), с конвейером инициатив (куда попадают идеи, родившиеся на сессии). Если обучение проведено, а инфраструктуры нет — попробовать негде, и обученные люди разочаровываются. Если инфраструктура есть, а обучения нет — никто не использует. Только все четыре практики вместе создают условия для реального движения.
11.6. Связь с другими практиками
На протяжении этого документа мы последовательно рассмотрели четыре практики корпоративной работы с ИИ: платформу (глава 8), безопасный периметр (глава 9), внешнюю инженерную команду (глава 10), обучение (эта глава). Каждая из них самостоятельна — может быть заказана отдельно, может приносить свой эффект изолированно. Но настоящая сила каждой проявляется только в связи с остальными.
Платформа без обученных пользователей — это набор контейнеров без живых процессов. Безопасный периметр без обученных операторов — это интерфейс, на который смотрит ИБ-блок, не понимая, как им управлять. Внешний офис без обучения внутри компании — это команда, которая уходит, оставляя за собой инфраструктуру, которую дальше некому развивать. И наоборот: обучение без работающей инфраструктуры — это «сходили на курс и забыли», потому что попробовать негде.
Поэтому правильный вопрос для руководителя ИТ или CEO компании, начинающей серьёзную работу с ИИ, — не «что выбрать из четырёх». Вопрос — «с чего начать и как двигаться». Какие практики нужны сейчас, какие — потом, в каком порядке, в какой последовательности. Этому вопросу — выбору стартовой точки и плана движения — посвящена финальная глава нашего документа.
Глава 12
Карта четырёх практик и выбор стартовой точки
Это финальная глава нашего документа. Её задача — собрать в единую картину всё, что было сказано в предыдущих одиннадцати главах, и дать практический ответ на главный вопрос читателя: с чего начать. Мы возвращаемся к нарративу всего документа в сжатой форме, показываем четыре практики корпоративной работы с ИИ как взаимосвязанную систему, предлагаем карту выбора стартовой точки для типовых ситуаций и заканчиваем рекомендацией первого конкретного шага.
12.1. О чём этот документ
Мы начали с фиксации проблемы: внедрение ИИ в крупной компании буксует не от нехватки технологий, а от нехватки системного подхода. Конкретные шесть проблем мы зафиксировали в главе 2 — от данных, не пригодных для ИИ, до зоопарка пилотов, который через год становится неуправляемым. Эти проблемы не уникальны и не сложны; они типовые и решаемые. Но решить их можно только в правильной последовательности и в правильной архитектуре.
В главе 3 мы перевели диагностическую часть в практический чек-лист: восемь ключевых вопросов, на которые должна отвечать любая стратегия внедрения ИИ — данные, безопасность, контур, модели, доступы, оборудование, эксплуатация, эффект. Любой подход, не закрывающий хотя бы один вопрос, в какой-то момент упирается именно в этот пропущенный вопрос. В главе 4 мы зафиксировали целевую архитектуру: единый ИИ-слой между корпоративными системами и бизнес-сценариями, с шестью базовыми инженерными возможностями — от AI Gateway до развёртывания и сайзинга.
В главе 5 мы показали, какие двусторонние эффекты даёт зрелый ИИ-слой: бизнесу — конвейер инициатив, ИТ — управляемость. В главе 6 развернули, что такое конвейер в операционной плоскости — пять стадий от идеи бизнеса до промышленной эксплуатации, с известными сроками и точками принятия решений. В главе 7 ввели карту зрелости с четырьмя группами метрик и тремя уровнями — Хаос, Управляемый, Зрелый — как инструмент самодиагностики и планирования трансформации.
Затем мы перешли к практической части. В главе 8 описали корпоративную ИИ-платформу как воплощение целевой архитектуры. В главе 9 раскрыли AI Guard — компоненту защищённого периметра, которая может поставляться отдельно для компаний, нуждающихся только в безопасности. В главе 10 описали Внешний офис ИИ — функциональную команду на ограниченный срок, играющую одну из одиннадцати ролей в зависимости от уровня зрелости заказчика. В главе 11 — обучение и стратегические сессии как четвёртую практику, без которой остальные три работают вполсилы.
Каждая глава решала свою задачу. Но настоящая ценность раскрывается в их совокупности. Об этом — следующий раздел.
12.2. Четыре практики как система
На рынке крупных российских компаний мы видим четыре устойчивых формата запроса к внешним партнёрам по теме ИИ. Они складываются в одну систему, но каждая практика может быть заказана отдельно и в этом случае приносит свой эффект.

Самостоятельная ценность каждой практики
Корпоративная ИИ-платформа «Камерата» — это полная реализация целевой архитектуры из главы 4. Она нужна компании, которая идёт на полноценное масштабирование ИИ-практики: десятки сценариев в эксплуатации, единый периметр, общая инфраструктура. Это инвестиция, которая окупается не на первом сценарии, а ближе к пятому-десятому — и поэтому имеет смысл только при настоящем намерении выйти на «Зрелый» уровень. Подробное описание — в главе 8.
AI Guard — это самостоятельный продукт, который закрывает одну, но самую блокирующую проблему: безопасный периметр работы с ИИ. С точки зрения целевой архитектуры он реализует две из шести базовых возможностей: безопасность с ролевой моделью и часть AI Gateway. Может внедряться независимо от платформы, в существующий ИТ-ландшафт заказчика, без переписывания приложений. Это правильный выбор для компании, которой нужно срочно снять регуляторный риск, но пока рано инвестировать в полноценную платформу. Полное описание — в главе 9.
Внешний офис ИИ — это прикладная инженерная команда на ограниченный срок. Не консультанты, не штатные сотрудники, а функциональная команда, которая на конкретный этап становится частью компании и руками делает работу. Одиннадцать ролей в четырёх фазах работы — от диагностики до прикладных сценариев — позволяют выбрать ту функцию, которая нужна именно сейчас. Это правильный выбор, когда нужна инженерная экспертиза, которой нет внутри. Описание ролей и фаз — в главе 10.
Обучение и стратегические сессии — это подготовка людей к работе с ИИ. Три уровня обучения по карте зрелости (от «что такое ИИ» до развития внутреннего тренерского ядра) и семь форматов под разные слои организации. Эта практика нужна и компаниям, которые только знакомятся с темой, и компаниям, которые уже строят полноценную инфраструктуру (потому что инфраструктуре нужны обученные пользователи). Подробно — в главе 11.
Связь между практиками
Каждая практика самостоятельна, но их сила раскрывается в связи. Платформа без обученных пользователей — это набор контейнеров без живых процессов: технически работает, никем не используется. Безопасный периметр без обученных ИБ-операторов — это интерфейс, на который смотрит ИБ-блок, не понимая, как им управлять; через полгода превращается в формальный артефакт без реального контроля. Внешний офис без обучения внутренней команды — это команда, которая уходит, оставляя за собой инфраструктуру, которую дальше некому развивать. И наоборот: обучение без работающей инфраструктуры — это «сходили на курс и забыли», потому что попробовать негде.
Поэтому правильное планирование работы с ИИ — это не «выберите одну из четырёх практик», а «соберите правильную последовательность из четырёх». На каждом этапе зрелости компании одна или две практики приоритетны, другие — поддерживающие. Через год последовательность меняется. Это движение по карте зрелости в реальности и есть та самая корпоративная ИИ-практика, которой посвящён весь этот документ.
12.3. Карта выбора стартовой точки
Главный практический вопрос для руководителя крупной компании, который дочитал этот документ до этой точки: «у нас в компании ситуация X — с чего начать». Ниже мы предлагаем карту, которая отвечает на этот вопрос для семи типовых ситуаций. Это не исчерпывающая классификация, но она покрывает большинство реальных случаев, которые мы встречаем в работе с заказчиками.
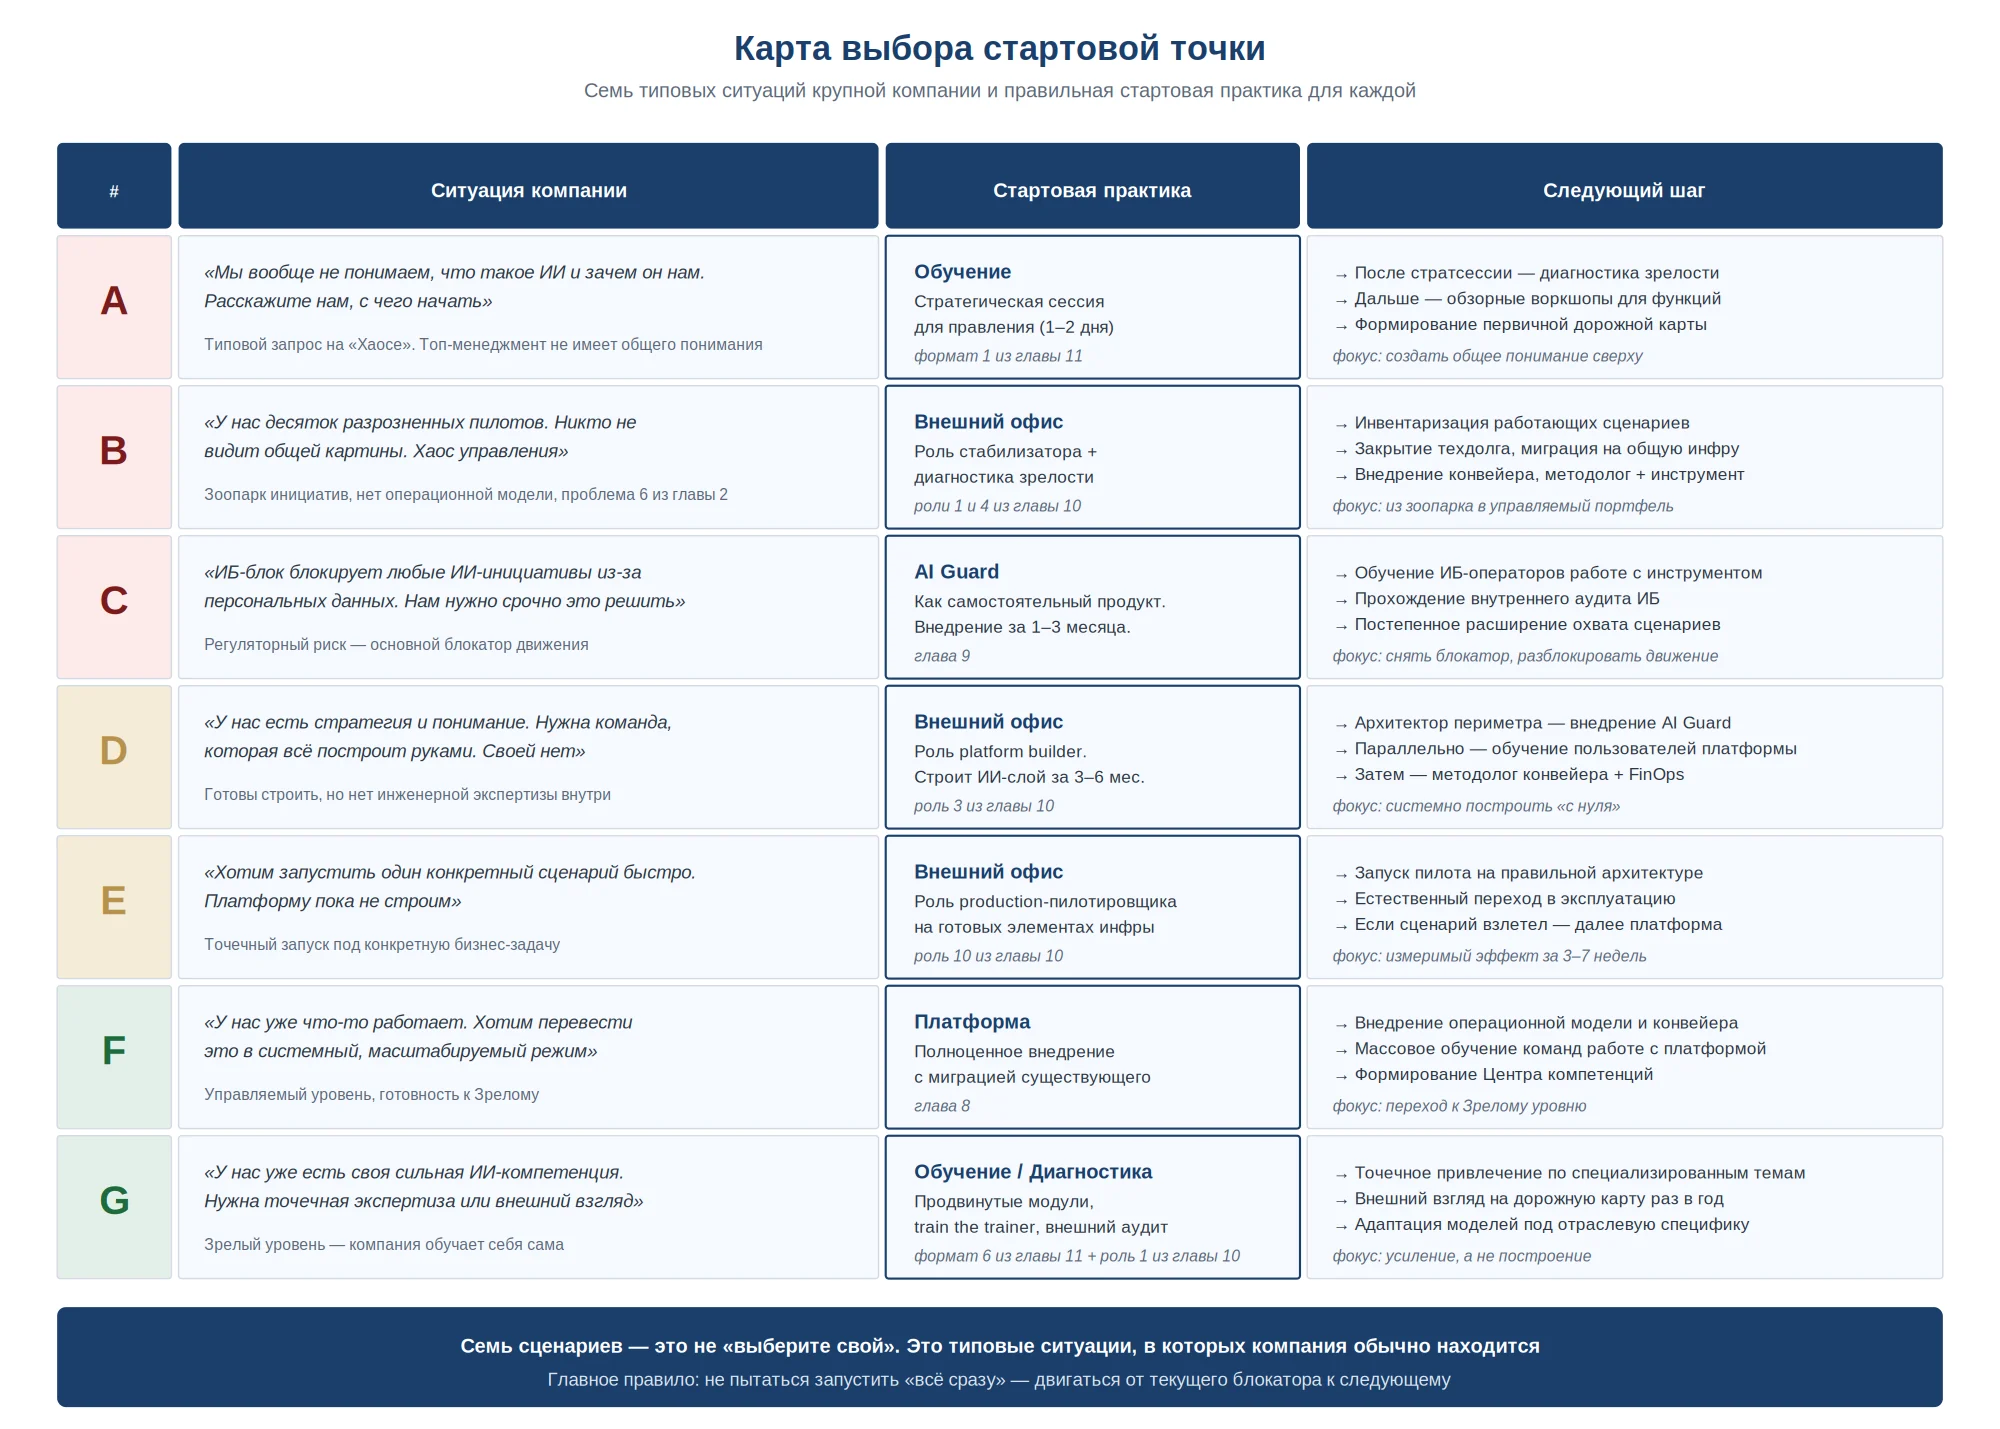
12.4. Семь типовых сценариев входа
Ниже — расшифровка каждого сценария: какую ситуацию он описывает, почему именно эта стартовая практика правильна, какова последовательность действий после неё.
Сценарий A. «Мы вообще не понимаем, что такое ИИ»
Типовая ситуация на уровне «Хаос». У правления есть смутное ощущение, что нужно «что-то делать с ИИ», но нет общего понимания: что такое корпоративный ИИ применительно к их бизнесу, какие задачи им можно решать, с чего начать, как считать эффект. В этой ситуации обсуждать архитектуру или строить платформу преждевременно: любое решение будет приниматься на основе случайных представлений отдельных людей.
Правильная стартовая практика — обучение, конкретно — стратегическая сессия для правления продолжительностью один-два дня. Цель сессии: сформировать единый словарь между блоками компании, разобрать ландшафт ИИ через призму конкретной отрасли, обсудить применимость к собственным процессам, в конце сформировать первичную дорожную карту. После такой сессии становится возможным следующий шаг — диагностика зрелости и обзорные воркшопы для функций, чтобы каждое подразделение начало думать про конкретные применения ИИ у себя.
Сценарий B. «У нас зоопарк пилотов, не управляются»
Типовая ситуация на пограничном уровне между «Хаосом» и ранней «Управляемостью». В компании уже работают несколько ИИ-инициатив — внедрённых в разное время, разными командами, на разных стеках. Что-то на ChatGPT через прокси, что-то на GigaChat, что-то на коробочном ассистенте. Никто не видит общей картины, никто не управляет портфелем целиком. Через год накапливается технический долг, безопасность не покрыта, расходы непрозрачны. Это проблема 6 из главы 2.
Правильная стартовая практика — Внешний офис в двух ролях одновременно: роль 4 (стабилизатор существующих проектов) и роль 1 (аудитор зрелости). На первом этапе проводится инвентаризация всех работающих ИИ-инициатив, оценка их состояния, закрытие технического долга, миграция перспективных сценариев на общую инфраструктуру. Параллельно — диагностика зрелости компании. После этого естественно следует роль 5 — методолог конвейера, который превращает разрозненную работу в управляемый портфель с регламентами и инструментом управления.
Сценарий C. «ИБ блокирует любые ИИ-инициативы»
Типовая ситуация в компаниях с регулируемыми данными — банки, страховые, медицинские организации, госсектор. У бизнеса есть идеи по применению ИИ. У ИТ есть техническая возможность реализовать. Но ИБ-блок справедливо блокирует все инициативы, потому что не уверен в защите персональных данных и коммерческой тайны. Это самый распространённый блокатор движения, который мы видим на рынке.
Правильная стартовая практика — AI Guard как самостоятельный продукт. Внедрение занимает один-три месяца, после чего ИБ-блок получает работающий безопасный периметр с единой политикой, аудитом и контролем. После этого открывается возможность последовательно расширять охват сценариев — каждый из них уже работает в правильном контуре. Параллельно — обучение ИБ-операторов работе с инструментом и прохождение внутреннего аудита ИБ. Это самый чистый «разблокирующий» сценарий: одна точная инвестиция снимает основное препятствие движению.
Сценарий D. «У нас есть стратегия, нужна команда строить»
Ситуация компании, которая прошла стратегическую фазу и приняла решение строить корпоративный ИИ-слой. У руководства есть понимание, есть выделенные ресурсы, есть готовность инвестировать. Не хватает только одного — инженерной команды, которая руками построит платформу. Нанять такую команду в штат сложно (рынок специалистов узкий), консультантов недостаточно (они не строят, а рекомендуют).
Правильная стартовая практика — Внешний офис в роли platform builder. Команда становится временной инженерной силой компании на три-шесть месяцев и собирает корпоративный ИИ-слой как описано в главе 4: capabilities, архитектура, развёртывание, интеграции. Параллельно идут смежные роли: архитектор периметра внедряет AI Guard, обучение начинает работу с пользователями платформы, методолог запускает конвейер инициатив. Это самый системный сценарий — компания строит зрелую практику с нуля, без накопленных проблем и без зоопарка.
Сценарий E. «Хотим один сценарий быстро, без платформы»
Ситуация, в которой у компании есть конкретная бизнес-задача — например, ускорить подготовку коммерческих предложений, автоматизировать первичную обработку заявок, помочь юридическому блоку с проверкой договоров. Полноценную платформу строить пока не готовы (большая инвестиция, долго), но один сценарий нужно запустить.
Правильная стартовая практика — Внешний офис в роли production-пилотировщика. Принципиальное отличие от типового «пилота в песочнице»: сценарий собирается на правильной архитектуре или на готовых элементах инфраструктуры, с самого начала в правильном контуре, с безопасностью и мониторингом. Срок — 3–7 недель для типового сценария. После этого пилот естественно переходит в эксплуатацию без отдельного «проекта переписывания». Если сценарий взлетел и компания готова масштабировать — следующий шаг идёт к платформе. Если нет — компания получила измеримый эффект на одной задаче, без дальнейших обязательств.
Сценарий F. «Что-то работает, хотим в системный режим»
Ситуация компании, которая прошла начальные стадии: есть работающие сценарии, есть базовая инфраструктура, есть команда, которая что-то поддерживает. Но всё это держится на отдельных людях и держится не системно. Хотят перейти от «работает у нас» к «масштабируется как часть бизнеса». Это типовая ситуация уровня «Управляемый», с готовностью к «Зрелому».
Правильная стартовая практика — полноценная платформа «Камерата» из главы 8. Внедрение включает миграцию существующих сценариев на общую инфраструктуру, внедрение операционной модели (конвейер инициатив из главы 6, FinOps, governance), массовое обучение команд работе с платформой и формирование внутреннего Центра компетенций. Это самый ресурсоёмкий сценарий, но и самый трансформирующий — после него компания работает в режиме «Зрелого» уровня и дальше развивается самостоятельно.
Сценарий G. «У нас уже есть сильная ИИ-компетенция»
Не каждая крупная компания нуждается в построении ИИ-практики «с нуля» — на рынке есть компании, у которых уже сформирована сильная внутренняя ИИ-команда. Это и крупные банки-лидеры, и ИТ-компании с собственной ML-практикой, и компании, которые много лет осознанно инвестировали в направление. У таких компаний есть всё своё: и архитектура, и платформа, и эксперты. И они тоже периодически зовут внешних — но не за тем же, за чем зовут «начинающие».
Правильная стартовая практика для таких компаний — обучение или диагностика, но в специализированных форматах. Продвинутые обучающие модули по узким темам, где у внутренней команды не хватает экспертизы (например, новый класс моделей или специфическая отраслевая адаптация). Train the trainer — для усиления внутренних тренеров. Внешний аудит зрелости — для «свежего взгляда» на собственную дорожную карту, который компания не может получить изнутри. Адаптация моделей под специфику — точечная инженерная экспертиза по узким темам. Фокус — усиление имеющегося, а не построение нового.
12.5. Первый шаг
Любой из семи сценариев предполагает в качестве первого шага либо стратегическую сессию, либо диагностику зрелости. Эти два формата устроены принципиально по-разному, но оба короткие, обозримые и не требуют от заказчика большой стартовой инвестиции.
Стратегическая сессия — для уровня «Хаос»
Подходит компаниям, которые ещё не сформировали общее понимание у топ-менеджмента. Один-два рабочих дня с правлением и ключевыми C-уровневыми руководителями. Цель — не «провести лекцию по ИИ», а провести продуктивную дискуссию: разобрать ландшафт ИИ-решений через призму конкретной отрасли, обсудить применимость к процессам компании, сформировать первичную дорожную карту. Результат — единое понимание у руководства и список приоритетных гипотез для следующего шага.
Диагностика зрелости — для уровней «Управляемый» и выше
Подходит компаниям, у которых уже что-то делается с ИИ — пилоты, эксперименты, какие-то работающие сценарии. Совместная работа с ИТ, бизнес-владельцами и ИБ-блоком по проходу через карту зрелости из главы 7: где компания сейчас по каждой из четырёх групп метрик, где сильна, где отстаёт, где есть несоответствие представлений между блоками. Срок — обычно две-четыре недели на интервью, анализ артефактов и финальный workshop с результатами. Результат — фиксированная картина текущего состояния и адресная дорожная карта перехода на следующий уровень.
Почему именно так — и почему оба формата недорогие
Принципиальная идея этих двух стартовых форматов — дать заказчику возможность принять осознанное решение о следующем шаге, не вложив в это большую инвестицию. Стратсессия и диагностика стоят на порядок меньше, чем любая из четырёх практик в полном объёме, но дают достаточно, чтобы понять: какая из практик подходит сейчас, в каком объёме, с каким приоритетом. Это правильный «нулевой шаг» для любой компании, серьёзно подходящей к теме корпоративного ИИ.
Если результат стратсессии или диагностики не привёл к решению идти дальше — это тоже нормальный исход. Компания получила картину, на которую может опираться. Если привёл — мы переходим к одной из четырёх практик, описанных в этом документе, в правильной последовательности и в правильном объёме.
12.6. Заключение
Этот документ описал наше представление о том, как должна быть устроена корпоративная работа с ИИ в крупной компании — от диагностики проблем до конкретных инструментов их решения. Мы постарались избежать двух крайностей. Первая — продуктовая презентация, в которой каждая страница убеждает в превосходстве конкретного решения. Вторая — академический трактат, в котором правильные мысли не доходят до практических действий. Между этими крайностями находится формат, который мы выбрали: документ, описывающий устройство, доказательный в технических деталях, и заканчивающийся практической картой выбора.
Главная мысль, к которой мы хотели подвести читателя: внедрение ИИ в крупной компании — это не про технологию. Технологии доступны и сравнительно понятны. Это про инфраструктуру, операционную модель, людей и последовательность шагов. Компании, которые выигрывают, не «купили лучшую модель» — они построили зрелую систему, в которой ИИ работает как функция, встроенная в основные процессы. Это не быстрый путь, но это путь предсказуемый: если правильно зафиксировать стартовую точку и правильно выстроить последовательность, то результат становится не вопросом удачи, а вопросом времени.
Если эта логика отозвалась — следующий шаг очевиден. Стратегическая сессия или диагностика зрелости. Без обязательств, в обозримые сроки, с понятным результатом. Дальше — то, что подскажет результат этого первого шага.
Обсудить подход для вашей компании
Напишите нам — разберём ваши задачи и покажем, как они выглядят с Камератой.